Czy z jednego obrazu można zrobić przydatne ujęcie produktu? Ile trzeba czekać i czy warto zwiększać ustawienia? Sprawdzamy to na słuchawkach, szklanej butelce i wnętrzu — pokazując obrazy wejściowe, gotowe filmy i czas ich powstania. Obliczenia wykonuje jeden serwer z kartą RTX PRO 6000 Blackwell Max-Q i 96 GB pamięci GPU.
W tym porównaniu najważniejszy jest gotowy materiał. Podajemy czas uzyskania pliku, pokazujemy obrazy wejściowe i udostępniamy filmy w różnych ustawieniach. Dzięki temu można ocenić zarówno szybkość, jak i to, czy uzyskany ruch rzeczywiście pasuje do własnego pomysłu.
Wynik w skrócie
Wszystkie 12 zaplanowanych filmów powstało poprawnie. Każdy trwa około 5,1 s, a jego generowanie zajęło od 5,0 do 38,2 minuty, zależnie od ustawień i sceny. To praca wykonywana z wyprzedzeniem, nie tworzenie filmu na żywo podczas rozmowy.
Najkrótszy wariant, 480p i 20 kroków, pozwalał sprawdzić pomysł w około 5 minut. Przy 720p i 40 krokach czekaliśmy około 38 minut. Różnica dotyczyła jednak nie tylko czasu: zmieniały się również ruch kamery, oświetlenie i końcowa kompozycja. Dlatego pokazujemy gotowe materiały, a nie samą tabelę z sekundami.
Chcesz najpierw zobaczyć efekt? Przejdź do słuchawek, butelki albo wnętrza. Pod każdym filmem znajdziesz ustawienia i czas jego wygenerowania.
Co właściwie robi Wan2.2?
Wan2.2 to rodzina modeli generujących wideo. Wybraliśmy odmianę I2V-A14B, czyli tworzenie filmu na podstawie obrazu i opisu. Zdjęcie określa wygląd sceny, a tekst mówi na przykład: „powoli zbliż kamerę do produktu”. To inny rodzaj pracy niż montaż istniejącego nagrania lub dokładne odtworzenie projektu 3D. Model przewiduje ruch; nie zna fizycznej budowy przedstawionego przedmiotu.
Wan2.2 generuje film, ComfyUI łączy etapy pracy, a PyTorch wykonuje obliczenia na GPU. Szczegóły środowiska opisujemy na końcu. Oficjalna dokumentacja Wan2.2 opisuje odmianę I2V-A14B i obsługiwane rozdzielczości, a instrukcja ComfyUI pokazuje natywny sposób jej uruchomienia.
W naszym teście filmy powstają na badanym serwerze, bez wysyłania generowania do płatnego API. Obrazy wejściowe są syntetycznymi ilustracjami przygotowanymi narzędziem AI poza tym serwerem. Nie są zdjęciami prawdziwych produktów ani fotografiami naszego sprzętu. Rozdzielamy te dwa etapy: tutaj mierzymy wyłącznie tworzenie wideo.
Co porównujemy i jak czytać wyniki?
Przygotowaliśmy trzy zadania: ujęcie słuchawek, prezentację szklanej butelki oraz powolny przejazd kamery przez wnętrze. Każde sprawdza trochę inną rzecz. Słuchawki mają wyraźny kształt, butelka dodaje odbicia i drobny napis, a pomieszczenie — proste linie oraz relacje między obiektami.
480p oznacza tutaj film 832 × 480 pikseli. 720p to 1280 × 720. Więcej pikseli daje więcej miejsca na szczegóły, ale również więcej pracy dla karty. Nie zakładamy z góry, że wyższa rozdzielczość automatycznie naprawi błędy ruchu czy napisów.
Porównujemy również 20 i 40 kroków łącznie. Krok jest kolejnym etapem tworzenia obrazu przez model. To nie klatka filmu i nie liczba zdjęć na sekundę. Dłuższy wariant daje modelowi więcej etapów obliczeń; o tym, czy różnica jest przydatna, decyduje gotowy klip, a nie sama wyższa liczba.
Główna seria obejmuje 3 sceny × 2 rozdzielczości × 2 ustawienia kroków, czyli 12 filmów. Przed nią wykonaliśmy osobną rozgrzewkę. Zestaw scen, ustawienia i kolejność zapisaliśmy przed uruchomieniem serii; galerie zawierają wszystkie 12 jej wyników.
Każdy klip ma 81 klatek odtwarzanych z szybkością 16 kl./s, czyli około 5,1 s. Serwer ma 96 GB pamięci systemowej RAM; karta dysponuje osobnymi 96 GB VRAM.
Wszystkie warianty korzystają z jednego ustalonego wcześniej ziarna losowania. Seed, czyli ziarno, wybiera konkretny wariant generowania przy tych samych ustawieniach. Każdy czas w tabeli pochodzi z jednego wykonania danej konfiguracji — nie jest średnią ani medianą. Ta seria nie określa powtarzalności czasu ani różnic między wieloma ziarnami.
Komentarze dotyczące wyglądu opieramy na sześciu próbkowanych klatkach każdego filmu. Pomagają porównać kompozycję, rozpoznawalne kształty i oświetlenie, ale nie zastępują pełnej oceny ruchu. Całe filmy udostępniamy poniżej.
Przykład 1: słuchawki i spokojny ruch kamery
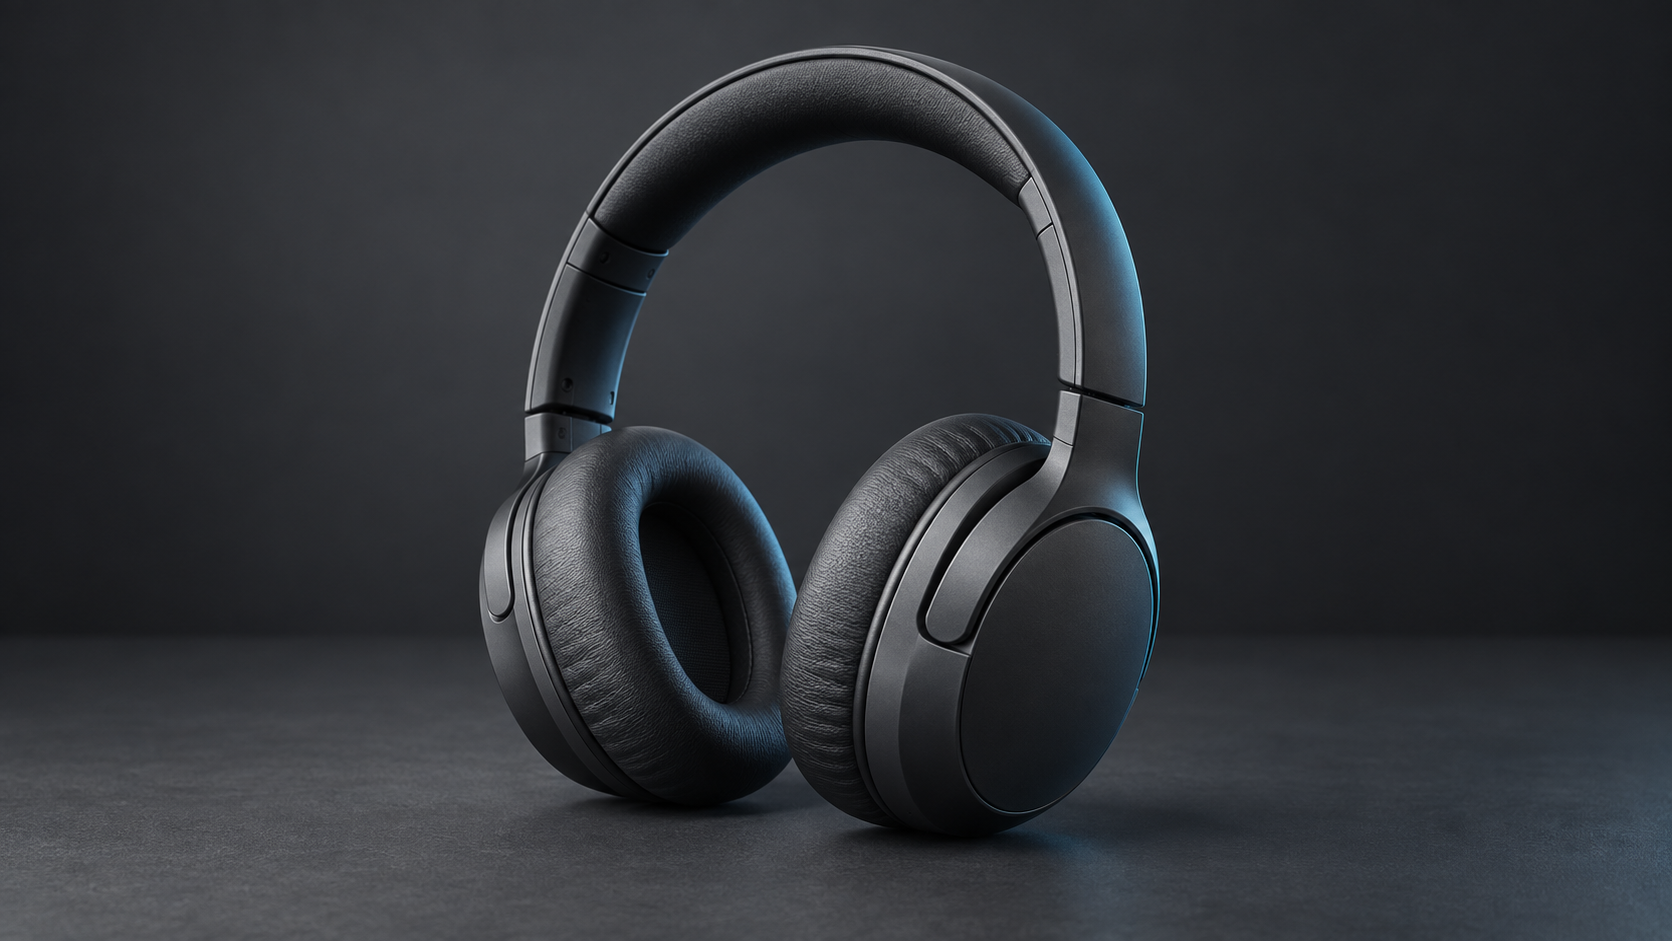
To najprostszy punkt wyjścia dla prezentacji produktu. Chcemy powoli podejść kamerą do przedmiotu, zachowując jego kształt, kolor i położenie. Nie prosimy o gwałtowny obrót ani pokazanie niewidocznego tyłu. Taki krótki ruch można rozważyć jako element strony produktu, planszę otwierającą prezentację lub fragment montowanego później materiału.
Podczas odtwarzania obserwuj kształt pałąka i obu nauszników.
Słuchawki — syntetyczny obraz wejściowy
Filmy bez dźwięku. Wybierz przycisk odtwarzania, aby uruchomić wybrany klip.
| Rozdzielczość | Kroki | Czas generowania [min] | Zaobserwowany szczyt VRAM [GiB] |
|---|---|---|---|
| 832 × 480 | 20 | 5,1 | 68,8 |
| 832 × 480 | 40 | 10,1 | 68,9 |
| 1280 × 720 | 20 | 18,9 | 69,5 |
| 1280 × 720 | 40 | 38,2 | 69,6 |
Na sprawdzonych klatkach słuchawki pozostają rozpoznawalne, a turkusowy refleks przemieszcza się po ich powierzchni. Jednocześnie zmienia się kąt patrzenia: pod koniec oglądamy oba nauszniki bardziej od przodu. Model nie wykonał więc wyłącznie prostego zbliżenia, lecz nadał prezentacji własny kierunek.
Warianty 20 i 40 kroków mają podobny ogólny charakter. W próbkach 720p z 40 krokami zewnętrzny bok prawego nausznika jest mocniej podświetlony niż przy 20 krokach. To różnica w wyglądzie ujęcia, nie dowód, że dłuższy wariant będzie zawsze lepszy.
Nasza ocena: wersja 480p z 20 krokami jest sensownym szkicem do sprawdzenia, czy taki sposób prezentacji pasuje do projektu. Zajęła 5,1 minuty, podczas gdy 720p z 40 krokami — 38,2 minuty. Wybierając materiał docelowy, warto obejrzeć pobrany plik w jego pełnej rozdzielczości: pomniejszone odtwarzacze nie pokazują całej różnicy w dostępnej liczbie pikseli.
W prawdziwym zleceniu punktem wyjścia byłoby własne zdjęcie, do którego mamy prawa. Najpierw warto sprawdzić jedno proste ujęcie. Jeśli zmienia się kształt produktu, piękne światło nie wystarczy, żeby uznać materiał za wierną prezentację. Z kolei dobry, spokojny ruch może być bardziej użyteczny niż efektowna animacja, która dopowiada nieistniejące elementy.
Przykład 2: butelka, odbicia i napis na etykiecie
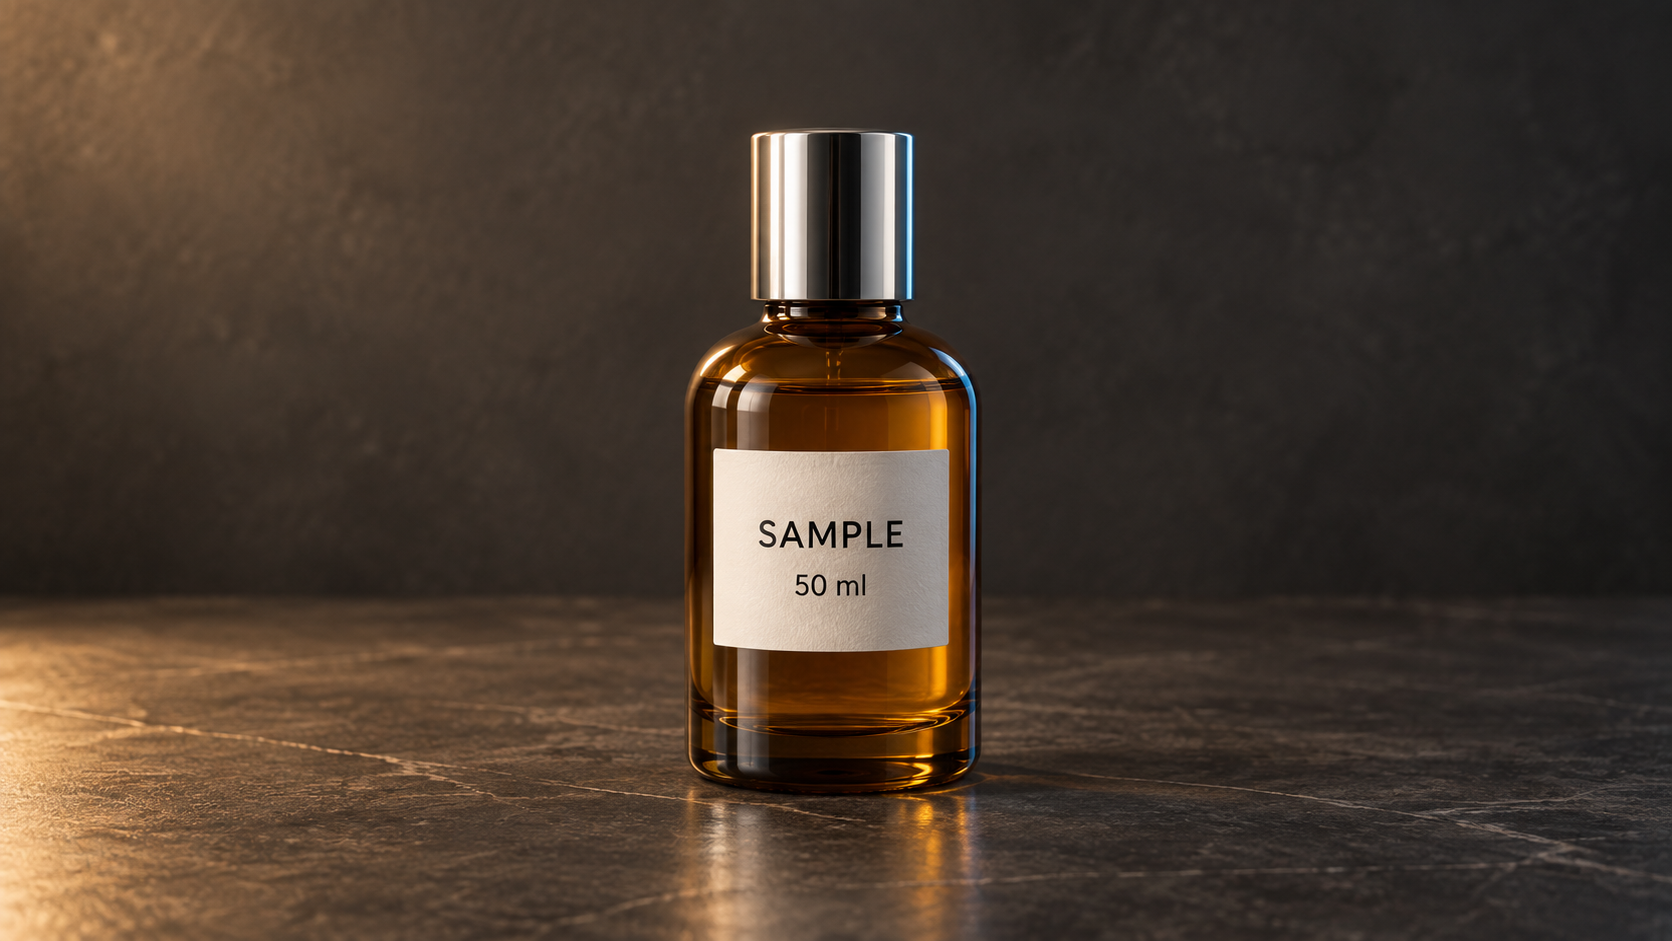
Szklana butelka jest trudniejsza: światło powinno zachowywać się wiarygodnie, kontur nie powinien pływać, a napis na etykiecie nie powinien się zmieniać. Dlatego obraz wejściowy zawiera krótkie „SAMPLE” i „50 ml”. To celowy element oceny, a nie reklama istniejącej marki.
Sprawdź, czy napis pozostaje czytelny także w ruchu, nie tylko na pierwszej klatce.
Butelka z etykietą SAMPLE — syntetyczny obraz wejściowy
Filmy bez dźwięku. Wybierz przycisk odtwarzania, aby uruchomić wybrany klip.
| Rozdzielczość | Kroki | Czas generowania [min] | Zaobserwowany szczyt VRAM [GiB] |
|---|---|---|---|
| 832 × 480 | 20 | 5,0 | 68,8 |
| 832 × 480 | 40 | 10,2 | 68,9 |
| 1280 × 720 | 20 | 19,2 | 69,5 |
| 1280 × 720 | 40 | 37,6 | 69,6 |
Butelka pokazuje, że większa liczba kroków nie musi oznaczać mocniejszego ruchu kamery. W próbkowanych klatkach oba warianty 480p wyraźnie przybliżają produkt. Zachowane są jego bursztynowy kolor, srebrna nakrętka i jasna etykieta; zmieniają się odbicia na szkle i blacie.
Przy 720p i 20 krokach zbliżenie jest bardziej powściągliwe. Przy 40 krokach mocniej rzucają się w oczy jasna plama po lewej stronie blatu oraz rozjaśnienie tła, podczas gdy sama butelka pozostaje podobnej wielkości. Etykieta jest rozpoznawalna jako jasne pole z dwoma wierszami, ale przegląd pomniejszonych klatek nie potwierdza wierności wszystkich liter w całym filmie.
Nasza ocena: do prezentacji zbliżającego się produktu wybralibyśmy najpierw próbę 480p z 20 krokami. Jeśli ważniejsza jest subtelna zmiana światła i materiału, warto porównać warianty 720p. Nie widać podstaw, aby tylko na podstawie tych próbek uznać najdłuższe ustawienie za najlepszą kompozycję. To wybór efektu, nie konkurs na największą liczbę kroków.
Praktyczne zastosowanie to przede wszystkim sprawdzenie koncepcji ujęcia, światła i ruchu. Gdy finalny materiał wymaga bezbłędnego logo, ceny, składu albo oznaczenia produktu, trzeba osobno skontrolować ich zgodność. W wielu projektach rozsądnie jest dodać ostateczny napis dopiero w programie montażowym. Samo wygenerowanie pliku nie oznacza akceptacji do publikacji.
Przykład 3: wnętrze i wrażenie przestrzeni
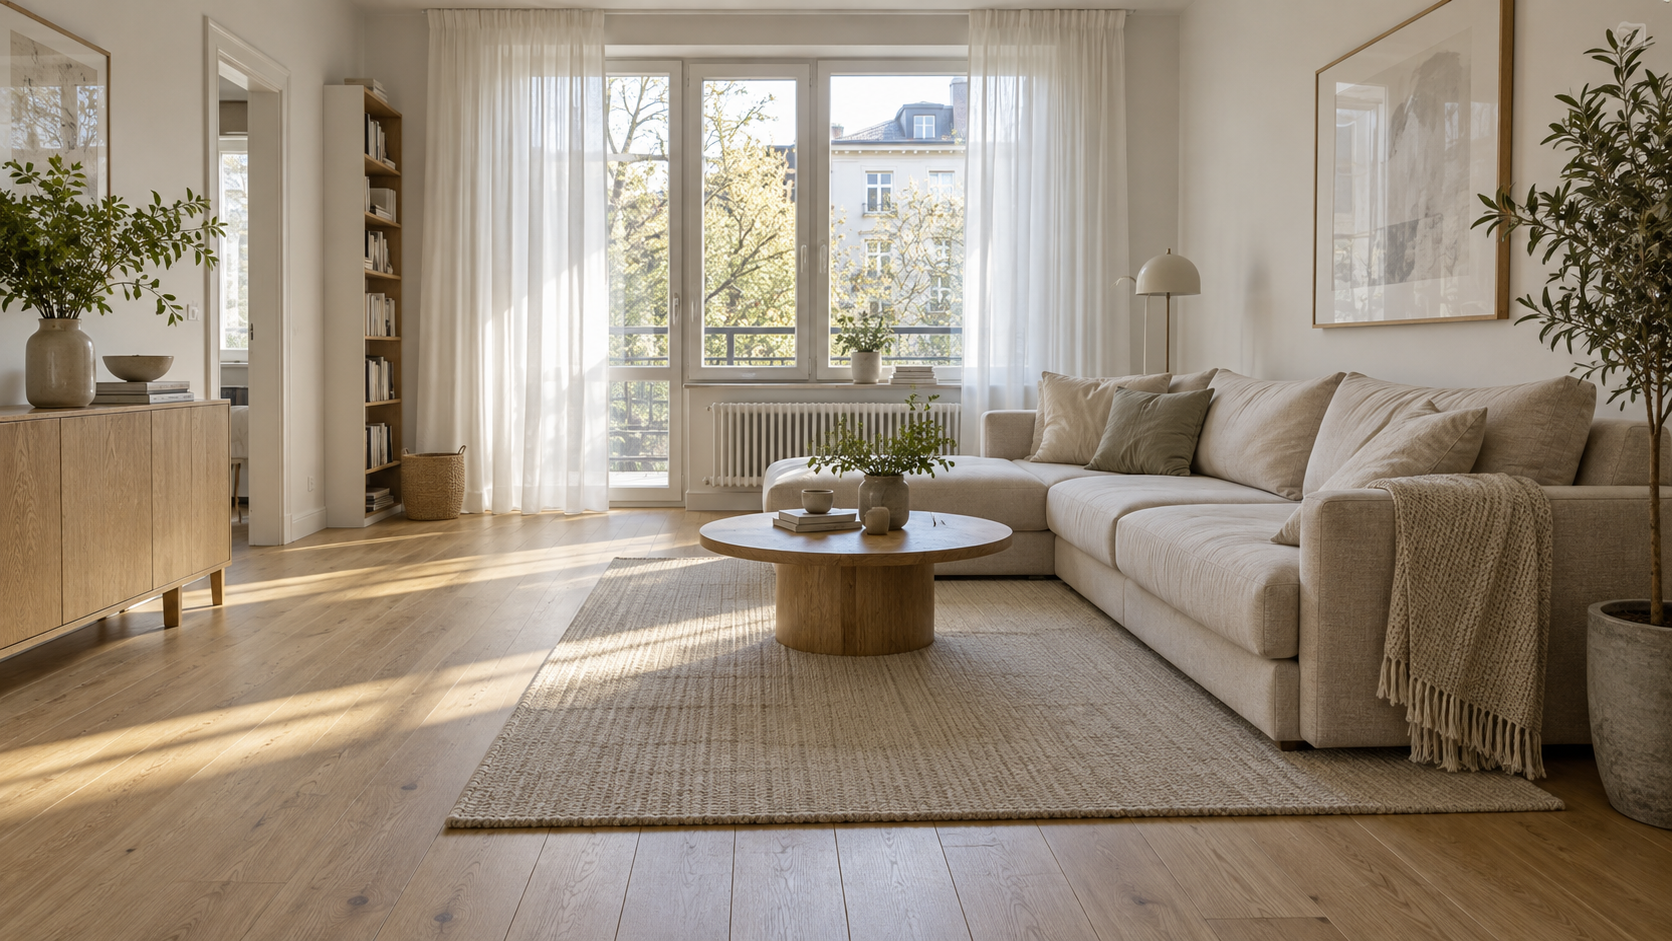
W tej scenie kamera ma powoli przesuwać się do przodu. Okno, podłoga i krawędzie mebli pomagają zauważyć, czy pomieszczenie zachowuje spójny wygląd. Delikatny ruch zasłony ma dodać życia bez przebudowy całej sceny.
Patrz na ramę okna i krawędzie mebli — czy zachowują spójny kształt podczas ruchu kamery?
Wnętrze salonu — syntetyczny obraz wejściowy
Filmy bez dźwięku. Wybierz przycisk odtwarzania, aby uruchomić wybrany klip.
| Rozdzielczość | Kroki | Czas generowania [min] | Zaobserwowany szczyt VRAM [GiB] |
|---|---|---|---|
| 832 × 480 | 20 | 5,2 | 68,8 |
| 832 × 480 | 40 | 10,0 | 68,9 |
| 1280 × 720 | 20 | 19,2 | 69,5 |
| 1280 × 720 | 40 | 37,9 | 69,6 |
We wnętrzu różnicę najłatwiej zauważyć po stoliku. W kolejnych próbkach zajmuje coraz więcej miejsca, a skrajne elementy pokoju wychodzą poza kadr. Oba warianty 480p kończą się zbliżoną kompozycją: stolik i sofa wypełniają większą część obrazu, ale ogólny układ salonu pozostaje rozpoznawalny.
W 720p z 20 krokami końcowy kadr nadal obejmuje niemal cały blat, a późniejsze próbki są jaśniejsze, zwłaszcza przy oknie i na podłodze. Najbardziej zdecydowane zbliżenie daje tutaj 720p z 40 krokami: na końcu stolik wychodzi poza dolną krawędź, a wazon i gałązki stają się dużym pierwszym planem.
Nasza ocena: ciaśniejsze ujęcie może dobrze pokazywać nastrój aranżacji i kierować uwagę na detal. Będzie mniej użyteczne, jeśli przez cały klip chcemy prezentować szeroki układ pomieszczenia. Przy tej scenie ważniejsze od samego pytania „czy obraz jest większy?” okazuje się pytanie „co zostaje w końcowym kadrze?”.
Takie ujęcia mogą służyć do prezentowania nastroju wnętrza, wstępnego pomysłu aranżacji lub kierunku wizualnego. Nie zastępują jednak dokładnej wizualizacji opartej na wymiarach i geometrii projektu. Jeżeli celem jest wierne pokazanie układu mieszkania, trzeba sprawdzić, czy AI nie przesunęła okna, mebla albo ściany. Do kontrolowanego renderowania scen 3D odnosi się nasz osobny test Blendera.
480p czy 720p? Najpierw cel, potem ustawienia
W tych próbach przejście z 480p na 720p, przy tej samej scenie i liczbie kroków, wydłużało generowanie około 3,7–3,8 raza. Zwiększenie liczby kroków z 20 do 40 wydłużało czas około 1,9–2,0 raza. Są to relacje między konkretnymi wykonaniami, nie gwarantowane mnożniki dla każdego przyszłego filmu.
Praktyczny punkt startu to 480p i 20 kroków: w naszej serii zajmował 5,0–5,2 minuty. Wariant 720p z 20 krokami wymagał 18,9–19,2 minuty, a z 40 krokami — 37,6–38,2 minuty. Dodatkowy czas warto wydawać na ujęcie, którego pomysł już nam odpowiada, zamiast podnosić wszystkie ustawienia z góry.
Niższa rozdzielczość może być użyteczna do sprawdzania kierunku ruchu i opisu sceny. Na tym etapie najważniejsze bywa to, czy kamera porusza się tam, gdzie chcemy, oraz czy produkt zachowuje swoją tożsamość. Kiedy ujęcie wygląda obiecująco, można przejść do wariantu z większą liczbą pikseli i ocenić szczegóły.
To sposób organizacji pracy, nie obietnica, że zwiększenie rozdzielczości odtworzy identyczny film. Nawet przy tym samym ziarnie zmieniają się obliczenia i wynik może się różnić. Porównuj więc konkretną parę klipów, a nie tylko ich nazwy.
W tej serii nie mierzymy natywnego 1080p ani 4K, zwiększania rozdzielczości po generowaniu ani dopisywania klatek przez dodatkowy model. Powiększony film nie jest automatycznie wynikiem generowania w wyższej rozdzielczości. Takie etapy wymagają osobnego pomiaru i oceny jakości.
Ile trwa praca: pierwszy film a następne próby
Pierwszy film rozgrzewkowy, słuchawki 480p z 20 krokami, powstał w 5,3 minuty. Uruchomienie ComfyUI zajęło osobno 5,0 s; łącznie start aplikacji i to zadanie trwały 5,4 minuty. Następna, mierzona próba tych samych ustawień zajęła 5,1 minuty.
Ta pojedyncza para pokazuje przebieg naszego uruchomienia. Nie wystarcza do wyznaczenia stałego zysku z rozgrzewki: potrzebne byłyby powtórzenia w kontrolowanych warunkach. Samo pobieranie modeli było zakończone wcześniej.
Czas generowania obejmuje wykonanie zadania i zapis MP4. Przy pierwszym zadaniu po uruchomieniu ComfyUI zawiera również potrzebne wczytanie modeli. Start samej aplikacji podajemy osobno. Pomiar nie obejmuje pobrania modeli ani przesłania filmu do użytkownika.
Warto o tym pamiętać przy planowaniu pracy. Serwer używany do wielu kolejnych wariantów ma inny rytm niż środowisko uruchamiane od zera do jednego krótkiego klipu. Nie przeliczamy jednak kilku przykładów na gwarantowaną liczbę zaakceptowanych reklam dziennie. Czas człowieka potrzebny na wybór ujęcia, poprawki i montaż pozostaje osobnym kosztem.
Co daje duża pamięć GPU?
W 12 głównych próbach zaobserwowane szczyty zajęcia pamięci GPU mieściły się między 68,8 a 69,6 GiB. Mierzyliśmy pamięć całego urządzenia, nie sam rozmiar plików modelu. Zestaw udało się uruchomić i wykonać na jednej karcie z 96 GB VRAM.
Pamięć używana w całym systemie RAM osiągała w tych próbach szczyty od 8,1 do 12,1 GiB, a osobno liczony RSS procesu ComfyUI — od 4,9 do 9,0 GiB. Rozgrzewka miała inne szczyty: 62,3 GiB VRAM, 12,4 GiB RAM hosta i 26,4 GiB RSS. Nie sumujemy tych wartości: użycie RAM systemu i RSS procesu mają inne definicje, a pamięć mapowana z plików może być uwzględniana w nich inaczej. Dokładny zakres odczytów opisujemy w części technicznej.
Najbardziej użyteczny wniosek jest prosty: badana konfiguracja poradziła sobie z całym zestawem. Te liczby nie oznaczają jednak, że środowisko wymaga tylko 12,4 GiB RAM ani że karta z dowolnie mniejszą pamięcią wykona te same zadania w ten sam sposób.
VRAM to pamięć bezpośrednio przy karcie graficznej. Mieszczą się w niej składniki modelu oraz dane potrzebne podczas generowania. RAM jest pamięcią systemową i pełni inną rolę. Duża pojemność GPU daje więcej swobody przy uruchamianiu wymagającego zestawu, ale sama nie mówi, jak dobry będzie film ani ile sekund zajmie konkretna scena.
Wyniki dotyczą testowanego serwera, wskazanego wariantu modelu i sposobu jego uruchomienia. Do porównania kart o mniejszej pamięci potrzebne byłyby osobne pomiary. Do tematu rozdzielania obliczeń i danych między GPU a pamięć systemową wracamy w porównaniu VRAM i RAM, dotyczącym osobno modeli językowych.
Dla kogo to może być dobry punkt wyjścia?
Dla zespołu kreatywnego interesująca jest możliwość wykonywania kolejnych wariantów na własnym zestawie narzędzi. Dla sklepu — sprawdzenie krótkich animacji wybranych produktów. Dla osoby przygotowującej wizualizacje — sprawdzenie pomysłu na ruch i atmosferę ujęcia. To proponowane zastosowania; nie przedstawiamy ich jako zmierzonych efektów sprzedażowych klientów.
W praktyce liczą się dwie rzeczy: czy uzyskany obraz jest użyteczny i czy czas przygotowania pasuje do sposobu pracy. Nie każdy materiał musi być filmem gotowym do emisji. Czasem wartościowym wynikiem jest szkic, który pomaga wybrać kierunek przed droższą produkcją. W innym przypadku liczy się wierna prezentacja produktu i wtedy wymagania wobec zgodności są znacznie większe.
Sam serwer GPU nie jest gotowym abonamentem w internetowym generatorze filmów. Trzeba przygotować środowisko, wgrać modele i ustalić sposób pracy. Ten artykuł pokazuje działający przepis oraz wynik jego sprawdzenia, a nie obietnicę automatycznego wdrożenia każdego programu po zakupie usługi. Zobacz konfigurację serwera albo opisz planowaną pracę z wideo.
Nasz wniosek
Wan2.2 na tym serwerze pozwala przejść od pojedynczego obrazu do krótkiego, gotowego do dalszej pracy pliku wideo. Pokazane przykłady dają trzy różne rezultaty: zmianę perspektywy produktu, grę światła na szkle i przejście od szerokiego widoku wnętrza do detalu. To konkretne materiały, które można obejrzeć, pobrać i ocenić we własnym projekcie.
Najlepiej sprawdza się tu myślenie etapami: najpierw krótka próba 480p, potem wybór kierunku, a dopiero później porównanie bardziej wymagających ustawień. W tej serii większa liczba kroków i wyższa rozdzielczość zwiększały czas, ale nie dawały jednego, bezdyskusyjnie najlepszego rodzaju ujęcia.
Dla osób, które chcą pracować z własnym środowiskiem i wykonywać kolejne warianty na jednym GPU, jest to działający punkt wyjścia. Najważniejsza decyzja pozostaje twórcza: czy pokazany ruch i kompozycja służą temu, co chcemy przedstawić? Dlatego obok wyników udostępniamy pełne filmy i ustawienia, zamiast zastępować ocenę materiału samą specyfikacją karty.
Szczegóły techniczne
Konfiguracja i granice pomiaru
| Element | Konfiguracja testowa |
|---|---|
| GPU | NVIDIA RTX PRO 6000 Blackwell Max-Q Workstation Edition, 96 GB VRAM |
| Limit mocy GPU | 300 W, bez ręcznego podkręcania |
| Procesor | AMD EPYC 4565P, 16 rdzeni / 32 wątki |
| RAM systemowy | 96 GB |
| System | Rocky Linux 10.2 |
| Sterownik NVIDIA | 595.91.07 |
| ComfyUI | 0.37.0, commit 73c9bad4d21e7addbe1d13bc92eee0f1431b017d |
| PyTorch / CUDA środowiska | 2.9.1+cu130 / 13.0 |
To konfiguracja faktycznie użyta w pomiarze. Wersje i sumy plików zapisaliśmy w załączonym protokole, aby późniejsza aktualizacja programu lub modelu nie zmieniła niezauważenie porównywanego zadania.
Wspólny przepis generowania to Wan2.2 I2V-A14B z dwoma ekspertami diffusion w FP16, tekstowym UMT5 w scaled FP8 i dekoderem wan_2.1_vae. FP16 i FP8 opisują format zapisu odpowiednich wag modelu; nie oznaczają rozdzielczości filmu. Nie korzystaliśmy z dodatkowych węzłów ComfyUI ani osobnego generatora, który poprawiałby wynik.
| Ustawienie | Wartość |
|---|---|
| Sampler / harmonogram | Euler / simple |
| CFG / shift | 3,5 / 5 |
| Podział kroków między ekspertów | 20 łącznie: 10 + 10; 40 łącznie: 20 + 20 |
| Liczba klatek / odtwarzanie | 81 / 16 kl./s |
| Liczba filmów w jednym zadaniu | 1 |
| Ziarno losowania | 104729 |
| Zapis | H.264, MP4, yuv420p, CRF 18, bez dźwięku |
| Przygotowanie obrazu | Skalowanie biliniowe i centralne kadrowanie do wymiarów filmu |
Rozdzielczości 832 × 480 i 1280 × 720 mają nieco inne proporcje. Oryginalne obrazy wejściowe mają 1672 × 941 pikseli. Porównanie dotyczy poziomych ujęć; nie jest testem pionowych rolek ani wymagań każdego wariantu Wan2.2.
Pomiar „pierwszego uruchomienia” oznacza nowy proces ComfyUI, bez czyszczenia pamięci podręcznej systemu. Kolejne zadania działają w tym samym procesie. Zachowane są węzły wczytujące modele, ale menedżer pamięci może częściowo zwalniać ich dane. Nie oznacza to, że wszystkie wagi pozostają przez cały czas w VRAM. Kodowanie opisu i obrazu, oba etapy generowania oraz dekodowanie klatek są wykonywane ponownie dla każdej próby.
Użyte opcje uruchomienia ComfyUI obejmowały --highvram --reserve-vram 8 --cache-classic --preview-method none. Są istotne przy odtwarzaniu zarządzania pamięcią, cache i wyłączenia podglądu podczas generowania. Dodatkowo ustawiliśmy --disable-metadata --disable-all-custom-nodes --disable-api-nodes; interfejs działał tylko lokalnie na serwerze. Sam plik workflow nie zastępuje tych parametrów programu.
Odczyty pamięci zbieramy mniej więcej co sekundę. Okno obserwacji obejmuje zadanie oraz końcowe sprawdzenie pliku; sam czas generowania kończy się wcześniej, po zapisie MP4. Szczyt w tabeli to najwyższa zaobserwowana próbka, a nie gwarantowane maksimum między odczytami. RAM hosta oznacza pamięć używaną w całym systemie, liczoną jako całkowita minus dostępna; RSS to osobny odczyt procesu ComfyUI. GiB jest jednostką binarną, zdefiniowaną jako 1024³ bajtów. Tych odczytów nie należy traktować jako minimalnych wymagań pamięciowych środowiska.
Jak odtworzyć porównanie
Pliki pod artykułem zawierają ustawienia, prompty, wyniki poszczególnych prób i przepis ComfyUI w formacie API. Taki plik jest przeznaczony do interfejsu API; nie jest obietnicą identycznego układu bloczków po przeciągnięciu do edytora. Sumy SHA-256 umożliwiają sprawdzenie, czy porównujemy te same pliki.
Ta seria ma identyfikator metodyki gsh-wan22-i2v/1.0. protocol.json opisuje środowisko i kolejność wykonania, a workflows.json zawiera komplet użytych opisów scen oraz ustawień. Opisy są zapisane po angielsku; polska i angielska wersja artykułu pokazują te same pomiary, nie dwa osobne testy.
- Przygotuj wersje ComfyUI, PyTorch i modeli wskazane w
protocol.json. Sprawdź sumy plików modeli, zamiast opierać się wyłącznie na ich nazwach. - Pobierz obrazy wejściowe z galerii. Udostępnione WebP są bezstratne: po odczytaniu mają te same piksele RGB co oryginalne PNG użyte w pomiarze.
- Z
workflows.jsonwybierz poleapi_promptodpowiedniej próby. W węźleLoadImagewskaż pobrany WebP zamiast pierwotnej nazwy PNG. Pozostaw prompt, rozdzielczość, kroki i seed bez zmian. - Dla każdego nowego wykonania ustaw świeżą wartość
_benchmark_nonce, jednakową we wszystkich pięciu węzłach z tym polem. Ten znacznik wymusza ponowne obliczenia w testowanej wersji ComfyUI; nie zmienia ziarna losowania. - Zachowaj oddzielny pierwszy przebieg rozgrzewkowy oraz zapisaną kolejność prób. Porównuj gotowe pliki i ten sam zakres czasu, nie sam komunikat samplera.
results.csv i results.json zawierają także rozgrzewkę, oznaczoną oddzielnie od 12 głównych prób. Pliki zachowują dokładność źródłowych liczb; w tekście i tabelach zaokrąglamy wyniki do jednego miejsca po przecinku. media-integrity.json opisuje zgodność obrazów i filmów przed oraz po przygotowaniu do publikacji. Oryginalny i publiczny workflow mają różne sumy, ponieważ prywatny znacznik wykonania zastąpiliśmy jawnym symbolem do wymiany.
Jak oceniamy wygląd filmu
Opis kompozycji, sylwetki przedmiotów i światła opieramy na sześciu próbkowanych klatkach każdego filmu: 0, 16, 32, 48, 64 i 80. Pozwala to porównać wygląd początku, kolejnych etapów i końca ujęcia. Nie jest pełną oceną ruchu ani potwierdzeniem braku migotania, zniekształceń pomiędzy próbkami czy zmian drobnych liter.
Osobno sprawdziliśmy techniczną poprawność wszystkich 12 MP4: wymiary, liczbę i czas klatek, odtwarzanie, pauzę oraz przewijanie w przeglądarce. Pliki przygotowaliśmy do pobierania strumieniowego bez ponownego kodowania obrazu. Porównanie wszystkich odczytanych klatek i ich znaczników czasu potwierdziło, że ten etap nie zmienił materiału.
Takie sprawdzenie potwierdza działanie plików, nie zastępuje oceny artystycznej. Pełne klipy pozostają dostępne w galerii, aby można było samodzielnie ocenić ruch i obejrzeć materiał w docelowym rozmiarze.
Wnioski dotyczą trzech pokazanych scen, nie ogólnego rankingu modeli wideo. Filmy są bez dźwięku, bez ręcznego poprawiania poszczególnych klatek i bez dokładania rezultatów z innych generatorów. Galerie pokazują wszystkie warianty należące do opublikowanego porównania, bez wybierania po obejrzeniu najładniejszego rezultatu.