Masz obraz, który dobrze oddaje pomysł. A gdyby poruszyć wodę w jeziorze, poprowadzić samochód przez zakręt albo zajrzeć z kamerą pod powierzchnię morza? Krótki film pozwala pokazać nie tylko wygląd sceny, lecz także jej atmosferę i tempo. Może otwierać prezentację, rozwijać pomysł na reklamę albo stać się ujęciem w większym montażu.
Sprawdzamy trzy sposoby wykonania takiego zadania: Wan2.2, LightWan2.2 i LTX-2.5. Każdy dostaje ten sam obraz danej sceny i opis oczekiwanego ruchu. Za obliczenia odpowiada jeden NVIDIA RTX PRO 6000 Blackwell Max-Q z nominalnie 96 GB pamięci GPU. Celem są filmy trwające około 15 sekund, w rozdzielczości 1280 × 704, z odgłosami pasującymi do scenerii.
Zacznij od domku nad jeziorem, rajdu na szutrze albo żółwia nad rafą. Przy każdym przykładzie najważniejsze są trzy pytania: czy ruch pasuje do pomysłu, czy materiał nadaje się do konkretnego zastosowania i ile trwa jego przygotowanie. Szczegółowe ustawienia dla osób, które chcą odtworzyć porównanie, zebraliśmy na końcu.
Najważniejsze wyniki w skrócie
W tej serii najszybciej powstały filmy LTX-2.5: zmierzony etap tworzenia obrazu razem z dźwiękiem zajął 1,2–1,5 min. LightWan2.2 potrzebował 2,6–2,7 min na niemy film; po doliczeniu osobnego audio suma wyniosła 3,8 min dla każdej sceny. Wan2.2 z późniejszym udźwiękowieniem osiągnął 121,8–122,5 min. To wyniki dziewięciu ukończonych filmów i sześciu osobnych etapów audio, nie prognoza dla dowolnego zadania.
Krótszy czas nie rozstrzyga jednak, który klip lepiej pasuje do projektu. W przejrzanych klatkach domku Wan i LightWan zachowują podobnie spokojną kompozycję, a LTX mocniej zmienia mgłę i oświetlenie. W rajdzie wszystkie trzy warianty sugerują powrót do kolejnego manewru, zamiast jednego zakrętu zakończonego odjazdem. Przy żółwiu różnice dotyczą przede wszystkim położenia zwierzęcia, światła i szczegółów anatomii. Są to obserwacje z nieruchomych próbek, nie ocena pełnej płynności ani dźwięku.
Trzy warianty, ale dwie rodziny modeli
Generowanie filmu z obrazu, czyli image-to-video, łączy gotową ilustrację z krótkim opisem akcji. Obraz określa wygląd i kompozycję, a tekst podpowiada dalszy ciąg: w którą stronę jedzie samochód, czy kamera stoi w miejscu i jak mocno faluje woda. To sposób na rozwinięcie pomysłu bez ręcznego animowania każdego elementu. Rezultat nadal wymaga obejrzenia, ponieważ model proponuje przebieg sceny, zamiast wykonywać dokładny plan animacji 3D.
Wan2.2 jest punktem odniesienia. LightWan2.2 należy do tej samej rodziny, lecz jest przygotowany do krótszego przebiegu obliczeń. LTX-2.5 reprezentuje drugą rodzinę i w wybranym profilu tworzy wspólnie obraz oraz dźwięk. Porównujemy więc trzy praktyczne konfiguracje z dwóch rodzin modeli — nie trzy zupełnie niezależne rozwiązania.
Wszystkie trzy sceny zaczynają się od syntetycznych ilustracji przygotowanych poza testowanym serwerem. Są przykładami kreatywnych zastosowań, nie nagraniami rzeczywistych miejsc, zawodów czy zwierząt. Wan i LightWan odtwarzamy z szybkością 16 klatek na sekundę, LTX — 24. Więcej klatek może dawać wrażenie płynniejszego ruchu; warto o tej różnicy pamiętać podczas oglądania.
Domek nad jeziorem: subtelny ruch, wyraźny punkt odniesienia
W spokojnym ujęciu łatwo zauważyć zmianę, której nie powinno być. Woda może falować, mgła przesuwać się nad powierzchnią jeziora, a pobliskie gałęzie lekko poruszać na wietrze. Domek, linia brzegu i góry powinny jednak pozostać na swoich miejscach. Kamera ma być nieruchoma, bez nagłego zbliżenia czy panoramy.
Wyobraź sobie otwarcie prezentacji o wypoczynku albo spokojny fragment filmu promocyjnego. Ruch ma ożywić kompozycję, ale nie odciągać uwagi od tytułu czy wypowiedzi prowadzącego. Dlatego nieruchoma kamera i delikatne zmiany otoczenia są tutaj ważniejsze niż efektowne przeloty.
Domek i spokojny krajobraz
Obraz wejściowy
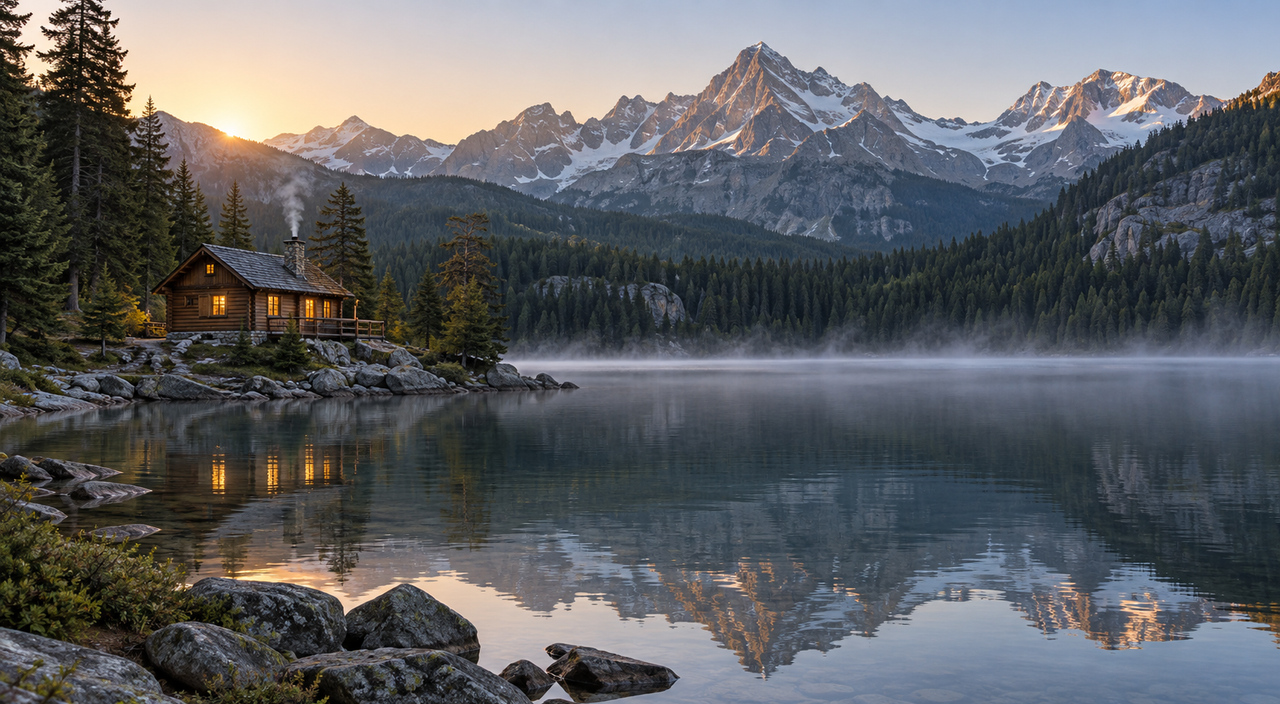
Każdy film ma dźwięk. Uruchom wybrany klip przyciskiem odtwarzania.
Parametry klipu
1280 × 704 · 16 fps · Klatki: 241 · Ziarno: 104729
Parametry klipu
1280 × 704 · 16 fps · Klatki: 241 · Ziarno: 104729
Parametry klipu
1280 × 704 · 24 fps · Klatki: 361 · Ziarno: 104729
Najłatwiej porównać wersje, wybierając najpierw jeden stały punkt: okno, dach albo linię brzegu. Później warto przenieść uwagę na mgłę i odbicia w wodzie. Dzięki temu można oddzielić zamierzony ruch od przypadkowej zmiany wyglądu sceny. W dźwięku szukamy podobnej oszczędności: delikatnej wody, wiatru i odległych ptaków.
W klatkach przejrzanych przez asystenta AI Wan i LightWan zachowują rozpoznawalny domek, zarys gór i linię brzegu w bardzo podobnych miejscach. Zmiany skupiają się na odbiciach, zmarszczkach wody i dymie z komina. LightWan kończy ujęcie wyraźniejszą, bardziej zakręconą smugą dymu; w Wan jest ona węższa. Oba zachowują ciepłe światło i świecące okna, bez widocznej w tych próbkach dużej deformacji budynku.
LTX interpretuje atmosferę swobodniej: mgła nad jeziorem staje się gęstsza, a późniejsze kadry są chłodniejsze i ciemniejsze niż obraz początkowy. Domek nadal jest rozpoznawalny, lecz odległe szczegóły miękną, a kompozycja pozostaje mniej stała. Daje to inny kierunek wizualny: dwa warianty Wan są bliższe spokojnemu punktowi wyjścia, LTX mocniej przekształca nastrój. Przegląd klatek nie potwierdza idealnie nieruchomej kamery ani płynności między próbkami.
Notatki o dźwięku (analiza maszynowa):
- Wan2.2: Analiza samego dźwięku wskazała łagodną melodię przypominającą fortepian lub klawisze, podczas gdy analiza z obrazem zgłosiła brak słyszalnego dźwięku. Raporty są sprzeczne i nie potwierdzają oczekiwanych odgłosów jeziora.
- LightWan2.2: Sam dźwięk opisano jako jednostajne, delikatne brzmienie dzwonka, a w analizie z obrazem wspomniano muzykę. Raporty nie potwierdzają odgłosów wody, wiatru ani ptaków.
- LTX-2.5: Analiza samego dźwięku wskazała ciągłe, łagodne brzmienie przypominające elektroniczne tło. Raport z obrazem opisał scenerię bez użytecznych obserwacji audio, więc nie potwierdza zgodności dźwięku z otoczeniem.
Rajd na szutrze: czy ruch układa się w jedną akcję?
Samochód ma wjechać w szeroki zakręt, przejść przez niego kontrolowanym poślizgiem, a następnie wyprostować tor jazdy i przyspieszyć. Koła powinny obracać się zgodnie z ruchem pojazdu, pył pozostawać za nim, a kamera śledzić akcję bez gubienia całego auta.
To bardziej złożone zadanie niż wprawienie dowolnego elementu w ruch. Kolejne klatki muszą sugerować ten sam samochód na tej samej drodze. Zmiana proporcji nadwozia, niespodziewany dodatkowy element lub skok położenia mogą sprawić, że pojedynczy kadr wygląda przekonująco, lecz całe ujęcie przestaje być użyteczne.
Praktyczne zastosowanie to ruchomy szkic spotu: zanim powstanie pełna produkcja, można sprawdzić pomysł na zakręt, pracę kamery i zakończenie ujęcia. Storyboard — plan kolejnych kadrów — dostaje w ten sposób tempo, którego nie pokaże nieruchoma ilustracja.
Samochód w ruchu
Obraz wejściowy
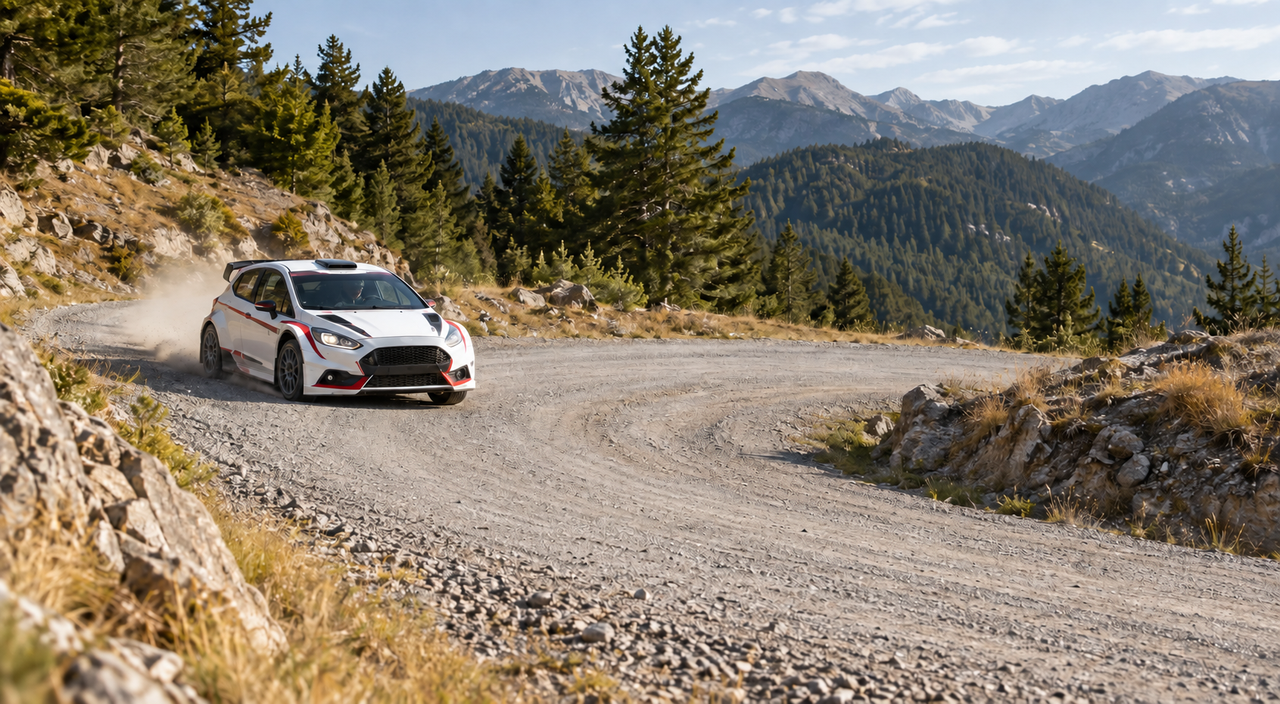
Każdy film ma dźwięk. Uruchom wybrany klip przyciskiem odtwarzania.
Parametry klipu
1280 × 704 · 16 fps · Klatki: 241 · Ziarno: 104729
Parametry klipu
1280 × 704 · 16 fps · Klatki: 241 · Ziarno: 104729
Parametry klipu
1280 × 704 · 24 fps · Klatki: 361 · Ziarno: 104729
Obejrzyj osobno początek, środek i koniec zakrętu. Czy akcja ma czytelny przebieg? Czy auto pozostaje tym samym autem, a pył podąża za nim? Potem włącz dźwięk: zmiana pracy silnika, szuranie opon i rozsypujący się szuter powinny wspierać to, co widać, zamiast tworzyć niezależne tło.
W próbkach Wan i LightWan można rozpoznać biały samochód z czerwonym pasem oraz kolejne widoki przodu, boku i tyłu. Za autem pojawia się pył. Około 8–10 s samochód znów jest widoczny od przodu po wcześniejszym oddaleniu: kadry sugerują kolejny przejazd lub manewr, a nie zamówiony pojedynczy zakręt i końcowy odjazd. W LightWan zmieniają się również niektóre szczegóły tylnej części nadwozia i kół. Tablic i drobnych oznaczeń nie należy traktować jako wiernego projektu auta.
LTX pokazuje bliższe ujęcie śledzące samochód, który zajmuje coraz więcej kadru. Tutaj także trasa zawraca, a późniejszy przejazd ma przeciwny kierunek na ekranie. Biało-czerwona tożsamość auta i duże tylne skrzydło pozostają czytelne, ale detale pasa i paneli nadwozia zmieniają się, a otoczenie jest miękkie lub rozmyte. Wszystkie trzy wyniki mogą służyć jako materiał do rozmowy o dynamicznym storyboardzie, lecz nie realizują po prostu całej zadanej sekwencji. Powracająca akcja pochodzi z generowania — nie dodawaliśmy pętli w montażu. Same klatki nie wystarczają do oceny obrotu kół, fizyki jazdy ani ciągłości ruchu.
Notatki o dźwięku (analiza maszynowa):
- Wan2.2: Bez obrazu model rozpoznał wzrost obrotów silnika i pisk opon pod koniec. Analiza z obrazem ogólnie powiązała te odgłosy z autem, ale nie pozwala potwierdzić dokładnej synchronizacji.
- LightWan2.2: Analiza samego dźwięku wskazała wzrost obrotów silnika i pisk opon; w analizie z obrazem silnik i wiatr pojawiają się tylko jako możliwe odgłosy. Zgodność czasowa z konkretnymi manewrami nie została potwierdzona.
- LTX-2.5: Analiza bez obrazu opisała silnik przechodzący z niskiego pomruku do wyższych obrotów. Raport z obrazem nie porównuje konkretnych zdarzeń dźwiękowych z manewrami, więc nie oceniamy dokładnej synchronizacji.
Żółw nad rafą: ruch i światło pod wodą
Trzecia scena przenosi akcję pod powierzchnię wody. Żółw ma spokojnie płynąć nad rafą, poruszając przednimi płetwami, a kamera delikatnie mu towarzyszyć. Ryby w tle powinny zachowywać własny ruch, bez zlewania się z rafą lub przepływania przez główny obiekt.
Podwodny charakter obrazu nie sprowadza się do niebieskiego koloru. Tworzą go także poczucie głębi, drobiny w wodzie, oświetlenie dna oraz zmieniające się refleksy na pancerzu. Jednocześnie kształt żółwia powinien pozostać rozpoznawalny przez całe ujęcie, nie tylko na początku.
Taki pomysł można wykorzystać jako ilustracyjną sekwencję w prezentacji, element projektu edukacyjnego albo spokojne przejście pomiędzy częściami filmu. Przydatny jest tu wyraźny podział planów: żółw prowadzi wzrok, a rafa, ryby i światło budują otoczenie.
Żółw pod wodą
Obraz wejściowy
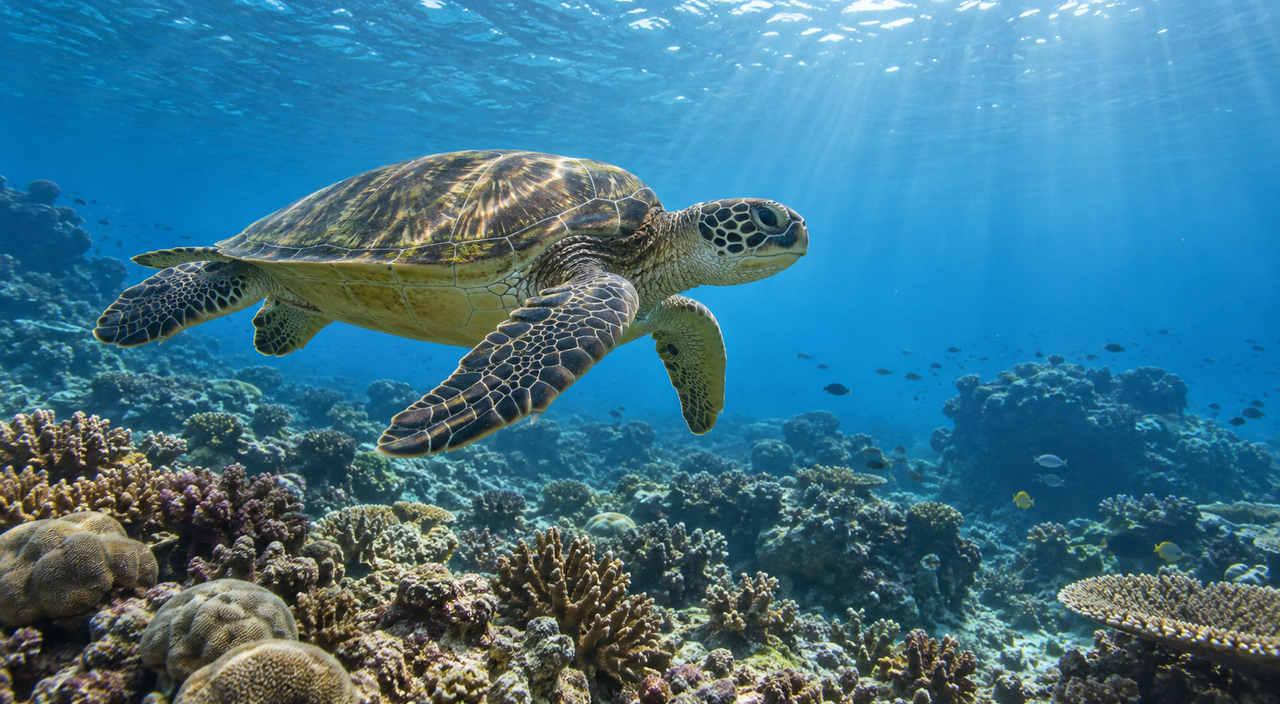
Każdy film ma dźwięk. Uruchom wybrany klip przyciskiem odtwarzania.
Parametry klipu
1280 × 704 · 16 fps · Klatki: 241 · Ziarno: 104729
Parametry klipu
1280 × 704 · 16 fps · Klatki: 241 · Ziarno: 104729
Parametry klipu
1280 × 704 · 24 fps · Klatki: 361 · Ziarno: 104729
Przy porównaniu warto śledzić jeden pełny ruch płetw, a następnie obejrzeć tło. Czy ryby poruszają się niezależnie? Czy światło zmienia się stopniowo? Zamówiony dźwięk to stłumiona atmosfera podwodna — inne zadanie niż wiatr i pluskanie przy jeziorze.
LightWan zachowuje jasną, turkusową kompozycję, promienie słońca i dużego żółwia blisko początkowego położenia. W wielu próbkach różnice ustawienia płetw są niewielkie, choć około 11–12 s widać uniesione płetwy i ich jaśniejsze spody. To powściągliwa interpretacja sceny, nie stwierdzenie, że obraz jest nieruchomy.
W Wan żółw nieco się oddala, a pozycje przednich płetw zmieniają się wyraźniej. Woda i pierwszy plan robią się ciemniejsze; później trudniej rozpoznać poszczególne ryby. LTX zachowuje jasną rafę, ale żółw stopniowo oddala się i obraca w stronę widoku od tyłu i z boku. W późniejszych próbkach tylna część sylwetki lub zasłonięta dalsza płetwa jest nietypowo wąska i wydłużona. Nie da się na tej podstawie rozstrzygnąć, czy odpowiada za to perspektywa, czy błąd anatomii. Każdy wynik zachowuje rozpoznawalnego żółwia, ale żaden przegląd nieruchomych kadrów nie potwierdza poprawności całego cyklu pływania ani niezależnego zachowania ryb.
Notatki o dźwięku (analiza maszynowa):
- Wan2.2: Analiza bez obrazu wskazała jednostajny niski pomruk lub odległy silnik; z obrazem ten sam dźwięk opisano jako ruch wody i możliwą aktywność zwierząt. Ta rozbieżność nie potwierdza naturalnych odgłosów podwodnych ani ich synchronizacji z ujęciem.
- LightWan2.2: Bez obrazu model opisał stały szum podobny do wiatru, o niepewnym źródle; po dodaniu obrazu wskazał bąbelki i możliwe odgłosy zwierząt morskich. Zmiana interpretacji nie stanowi potwierdzenia tych odgłosów ani dokładnej zgodności z akcją.
- LTX-2.5: Sam dźwięk model skojarzył z pracującym dużym silnikiem, a wraz z obrazem opisał go jako ruch wody. Rozbieżne raporty nie pozwalają potwierdzić naturalnej podwodnej atmosfery ani precyzyjnej zgodności z ruchem.
Dźwięk, który należy do sceny
Wiatr nad jeziorem, silnik na zakręcie i przytłumione odgłosy pod wodą pełnią różne role. W opisie prosimy wyłącznie o dźwięki otoczenia, bez lektora i muzyki; chodzi o atmosferę i zgodność z widoczną akcją. Te same przykłady można więc oglądać w polskiej i angielskiej wersji artykułu, bez przełączania języka narracji.
LTX tworzy obraz i dźwięk wspólnie. Wan i LightWan najpierw generują niemy film, a LTX Retake dodaje do niego odgłosy bez zmiany oryginalnego obrazu. Można więc najpierw ocenić animację, a później ją udźwiękowić. Porównujemy całe sposoby pracy; dźwięk we wszystkich trzech pochodzi z LTX.
Krótkie opisy dźwięku opieramy na analizie maszynowej, a uwagi o wyglądzie — na wybranych kadrach przejrzanych przez asystenta AI. Nie jest to odsłuch ani pełne obejrzenie filmu przez człowieka. W odtwarzaczu można samodzielnie porównać całe ujęcia; zakres naszej oceny wyjaśniamy w metodyce. Polecenie „bez muzyki” jest wskazówką dla modelu, nie gwarancją wyniku.
Ile trzeba czekać na film?
Piętnaście sekund to długość filmu. Na jego przygotowanie trzeba poczekać osobno — i właśnie ten czas pokazuje tabela. Czas tworzenia filmu obejmuje drogę od przygotowania modelu do zapisanego pliku, a nie tylko samą animację.
Tabela rozdziela tworzenie filmu, osobny dźwięk oraz sumę zmierzonych etapów. Dla LTX dźwięk jest już częścią tworzenia filmu, a nie dodatkowym etapem trwającym zero minut. Dla Wan i LightWan ten pomiar kończy się niemym filmem; osobna kolumna opisuje późniejsze udźwiękowienie.
Suma nie oznacza pełnego czasu oczekiwania w usłudze: nie obejmuje startu aplikacji, kolejek ani oceny gotowego materiału.
| Scena | Wariant | Tworzenie filmu [min] | Osobny dźwięk [min] | Suma etapów [min] |
|---|---|---|---|---|
| Domek nad jeziorem | Wan2.2 | 121,3 | 1,2 | 122,5 |
| Domek nad jeziorem | LightWan2.2 | 2,6 | 1,1 | 3,8 |
| Domek nad jeziorem | LTX-2.5 | 1,5 | wspólnie z obrazem | 1,5 |
| Rajd na szutrze | Wan2.2 | 121,1 | 1,1 | 122,2 |
| Rajd na szutrze | LightWan2.2 | 2,7 | 1,1 | 3,8 |
| Rajd na szutrze | LTX-2.5 | 1,2 | wspólnie z obrazem | 1,2 |
| Żółw nad rafą | Wan2.2 | 120,7 | 1,1 | 121,8 |
| Żółw nad rafą | LightWan2.2 | 2,7 | 1,1 | 3,8 |
| Żółw nad rafą | LTX-2.5 | 1,3 | wspólnie z obrazem | 1,3 |
Przy szukaniu pomysłu przydatny jest czas do pierwszego filmu. Przy przygotowaniu materiału do pokazania — suma filmu i dźwięku. To dwa różne etapy pracy: najpierw wybierasz ruch, który pasuje do projektu, potem oceniasz całe ujęcie. Tabela nie obejmuje czasu potrzebnego na oglądanie, montaż ani ewentualną kolejną próbę.
Ile obliczeń przypada na sekundę filmu?
Czas całego klipu mówi, jak długo czekaliśmy na wynik. Druga perspektywa to ilość pracy przypadająca na sekundę gotowego materiału. Przykładowo 15,1 s w tabeli oznacza około piętnastu sekund obliczeń na jedną sekundę filmu z dźwiękiem — nie piętnaście sekund długości filmu.
Poniższe wartości wyliczamy łącznie z trzech scen dla każdego wariantu: sumę zmierzonych czasów obrazu i dźwięku dzielimy przez łączną długość filmów lub liczbę ich klatek. Uwzględniamy przygotowanie modelu w każdym zadaniu. To przeliczniki ukończonych prób, a nie osobne pomiary tworzenia pojedynczej klatki.
| Wariant | Klatkaż filmu [kl./s] | Czas na 1 s filmu z dźwiękiem [s] | Średnio na 1 klatkę [s] |
|---|---|---|---|
| Wan2.2 | 16 | 486,7 | 30,4 |
| LightWan2.2 | 16 | 15,1 | 0,9 |
| LTX-2.5 | 24 | 5,2 | 0,2 |
W codziennej pracy najłatwiej korzystać z czasu całego klipu i czasu na sekundę materiału. Przelicznik na klatkę jest dodatkiem: LTX przygotowuje więcej klatek na sekundę odtwarzania niż pozostałe warianty. Żadna z tych liczb nie ocenia jakości obrazu, naturalności ruchu ani przydatności sceny do montażu.
Pięć minut przy 30 kl./s: co można oszacować?
Pięciominutowy film przy 30 kl./s zawiera 9000 klatek. Nie wygenerowaliśmy takiego filmu w tej serii, a nasze zmierzone klipy mają 16 lub 24 kl./s. Poniższa tabela jest wyłącznie orientacyjnym przeliczeniem kosztu obliczeń na 9000 klatek, przy założeniu proporcjonalnego wzrostu pracy i podobnych ustawień 1280 × 704. Nie jest wynikiem testu 30 kl./s ani potwierdzeniem możliwości wybranego profilu.
| Wariant | Arytmetyczny szacunek dla 9000 klatek z dźwiękiem |
|---|---|
| Wan2.2 | około 76 godzin |
| LightWan2.2 | około 2–2,5 godziny |
| LTX-2.5 | około 30–40 minut |
Zakładamy przygotowanie wielu krótkich ujęć, nie jednej ciągłej sekwencji pięciominutowej. Nie doliczamy montażu, oceny materiału, kolejki ani ponownego generowania scen. Dłuższe zadania mogą wymagać innej ilości pamięci i skalować się inaczej, dlatego rzeczywisty czas trzeba sprawdzić w osobnej próbie.
Samo zapisanie pliku jako 30 kl./s nie oznacza wygenerowania większej liczby klatek: dla tej samej sekwencji może jedynie przyspieszyć odtwarzanie. Uzupełnianie klatek między istniejącymi to jeszcze inny, dodatkowy proces. Nie mierzyliśmy go tutaj, więc tabela nie opisuje czasu takiego sposobu przygotowania filmu. Jeżeli generujemy mniej klatek i dopiero później uzupełniamy je do 30 kl./s, potrzebny jest osobny pomiar.
Pamięć: ile miejsca zajmuje zadanie na GPU?
Testowany komputer ma 96 GB systemowej pamięci RAM. Karta ma osobne, nominalne 96 GB VRAM. Nie jest to jeden wspólny zasób 192 GB: system i programy korzystają z RAM, a GPU z własnej pamięci podczas obliczeń.
VRAM to pamięć karty, w której znajdują się dane potrzebne do jej obliczeń. W tabeli pokazujemy najwyższy zaobserwowany poziom jej zajęcia, osobno dla filmu i późniejszego audio. Jednostka GiB pochodzi z narzędzi pomiarowych; nominalną pojemność sprzętu podajemy w GB.
| Scena | Wariant | VRAM: film [GiB] | VRAM: osobny dźwięk [GiB] |
|---|---|---|---|
| Domek nad jeziorem | Wan2.2 | 81,1 | 77,7 |
| Domek nad jeziorem | LightWan2.2 | 53 | 77,7 |
| Domek nad jeziorem | LTX-2.5 | 29,2 | wspólnie z obrazem |
| Rajd na szutrze | Wan2.2 | 81,1 | 77,7 |
| Rajd na szutrze | LightWan2.2 | 53 | 77,7 |
| Rajd na szutrze | LTX-2.5 | 29,2 | wspólnie z obrazem |
| Żółw nad rafą | Wan2.2 | 81,1 | 77,7 |
| Żółw nad rafą | LightWan2.2 | 53 | 77,7 |
| Żółw nad rafą | LTX-2.5 | 29,2 | wspólnie z obrazem |
Pamięć filmu i osobnego dźwięku nie sumuje się tutaj: etapy działają kolejno, nie jednocześnie. Warto zauważyć, że w przypadku LightWan osobne udźwiękowienie zajmuje więcej VRAM niż tworzenie obrazu. Dodatkowe pomiary energii zachowujemy w rozwijanych szczegółach technicznych.
Jak podejść do wyboru wariantu?
Zacznij od zadania, nie od nazwy modelu. Projektant szukający kierunku reklamy może przede wszystkim potrzebować szybkich wersji roboczych. Montażysta przygotowujący spokojne otwarcie skupi się na kompozycji. W sekwencji sportowej ważniejszy może być czytelny przebieg akcji niż szczegółowość pojedynczego kadru.
Jeżeli priorytetem jest szybkie sprawdzenie pomysłu z obrazem i dźwiękiem, LTX ma w tej serii najkrótszy zmierzony etap: 1,2–1,5 min. Trzeba jednak zaakceptować, że może mocniej odejść od początkowego oświetlenia i kompozycji, jak przy domku, albo wymagać uważnej kontroli anatomii, jak przy żółwiu. Krótki czas daje szybszy materiał do oceny, nie automatyczną zgodę na użycie go w gotowej produkcji.
LightWan jest tutaj praktycznym punktem wyjścia do szybkich niemych szkiców: 2,6–2,7 min, a po udźwiękowieniu 3,8 min sumy etapów. W próbkach domku utrzymuje podobnie spokojną kompozycję jak Wan, a przy żółwiu pozostaje blisko jasnego obrazu wejściowego. Osobny dźwięk podnosi jednak zaobserwowane zajęcie VRAM z 53 GiB dla filmu do 77,7 GiB w etapie Retake. Planując zasoby, trzeba więc uwzględnić cały sposób pracy, nie tylko szybki etap wideo.
Wan w tej konfiguracji oznacza ponad dwie godziny zmierzonych etapów na scenę. Taki koszt warto wiązać z konkretną cechą poszukiwanego wyniku, a nie samym założeniem, że dłuższe obliczenia dadzą lepszy film. Przy rajdzie żaden z trzech wariantów nie pokazuje w próbkach jednoznacznego zakończenia zgodnego z opisem. Do dokładnie zaplanowanej reklamy auta trzeba więc osobno sprawdzić przebieg całego ujęcia i geometrię pojazdu; te przykłady są użyteczne przede wszystkim jako porównanie pomysłów, nie gotowy wzorzec wiernej animacji produktu.
Własny serwer GPU daje miejsce do pracy z różnymi wariantami oraz kontrolę nad ich ustawieniami. Dobrym następnym krokiem jest wybranie reprezentatywnego obrazu i prostego zadania: jeden ruch obiektu, określona kamera i jasny koniec ujęcia. Wtedy łatwiej ocenić, czy film rzeczywiście przybliża projekt do gotowego materiału.
Jeśli planujesz podobne eksperymenty, zobacz konfigurację serwera do pracy z wideo. Opisane tu wyniki pokazują konkretne ustawienia i przykłady, nie gwarantowany czas wykonania dowolnego projektu.
Kilka praktycznych pytań
Jeśli chcesz najpierw porównać krótsze ujęcia i wpływ rozdzielczości, zajrzyj do wcześniejszego testu Wan2.2 w 480p i 720p. Tam pokazujemy inne zastosowania: produkt i wnętrze. Tutaj skupiamy się na dłuższej scenie, różnych sposobach generowania i dźwięku.
Czy model zachowa dokładny wygląd produktu?
Obraz wejściowy jest punktem odniesienia, nie gwarancją niezmienności każdego detalu. Kształt, oznaczenia, proporcje i zachowanie obiektu trzeba sprawdzić w całym ujęciu. Udany kadr początkowy nie wystarcza do zaakceptowania materiału produktowego.
Czy około 15 sekund oznacza możliwość stworzenia pięciu minut w jednym przebiegu?
Nie wynika to z tego porównania. Dłuższy projekt wymaga osobnego sprawdzenia generowania, spójności scen i zapotrzebowania na zasoby. Plan ujęć oraz montaż są innym zadaniem niż wytworzenie jednego kilkunastosekundowego klipu. Nie wydłużamy przykładów pętlą, zwolnieniem odtwarzania ani powtarzaniem klatek.
A co z użyciem komercyjnym?
Kod Wan i karta przypiętej wersji LightWan wskazują Apache-2.0. Sprawdzenia wymagają również licencje konkretnych wag i dodatkowych komponentów.
LTX-2.5 ma LTX-2.x Community License, wskazaną w repozytorium. Przy komercyjnym użyciu próg co najmniej 10 mln USD rocznych przychodów, z uwzględnieniem definicji wspólnej kontroli, wymaga płatnej licencji. Pozostałe warunki obowiązują także poniżej progu i dotyczą również audio z Retake. To skrót, nie potwierdzenie uprawnień konkretnej firmy; przed wdrożeniem trzeba sprawdzić warunki swojego użycia, dystrybucji lub usługi.
Szczegóły techniczne
Tutaj zebraliśmy metodykę i ustawienia potrzebne do odtworzenia porównania.
Wejścia, ustawienia i pojedynczy wynik
Porównanie obejmuje trzy sceny i trzy warianty: po jednym finałowym filmie dla każdej pary, czyli dziewięć ujęć. Do Wan i LightWan dochodzi sześć osobno mierzonych etapów audio. Pilotaże sprawdzają działanie środowiska i nie wchodzą do wyników finałowych. Do tabel dopuszczamy wyłącznie ukończone przebiegi; próbę przerwaną przed uzyskaniem poprawnego pliku powtarzamy z tymi samymi ustawieniami, zachowując jej dzienniki. Nie wybieramy po cichu najładniejszego ujęcia z wielu prób. Jeden przebieg pokazuje konkretny wynik, nie średnią, medianę ani różnice między kolejnymi uruchomieniami.
W obrębie sceny wspólne są znormalizowany PNG 1280 × 704, główny opis i ziarno 104729. Mechanizmy prowadzenia generowania nie są identyczne. Wan otrzymuje również opis negatywny, czyli listę niepożądanych cech obrazu. Wybrane destylowane profile LightWan i LTX nie korzystają z takiego opisu. Ziarno zapisuje punkt startowy losowania, ale nie zapewnia jednakowego szumu między architekturami ani plików identycznych bajtowo na innym środowisku. Dokładne rewizje kodu, wag i ustawień należą do zapisu próby.
| Wariant | Profil obliczeń | Klatki i odtwarzanie | Audio |
|---|---|---|---|
| Wan2.2 | I2V-A14B, 20 kroków, eksperci dyfuzyjni FP16; enkoder tekstu UMT5 scaled FP8 | 241 klatek, 16 kl./s | Osobny LTX Retake |
| LightWan2.2 | 4 kroki, destylowany profil dyfuzyjny NVFP4, sparse attention | 241 klatek, 16 kl./s | Osobny LTX Retake |
| LTX-2.5 | Destylowany profil transformera NVFP4, 8 kroków przy 640 × 352 i 3 kroki dopracowania przy 1280 × 704 | 361 klatek, 24 kl./s | Wspólnie z obrazem |
LTX wykorzystuje powiększenie przestrzenne między etapami oraz dekoder Conv VAE. Punkty odniesienia to dokumentacja Wan, konfiguracja LightX2V i pipeline LTX. Liczby kroków nie są wspólną jednostką pracy: stosunek 20 do 4 nie przewiduje różnicy szybkości ani jakości. Porównanie obejmuje całe konfiguracje, nie wpływ jednej opcji.
Ustawienia próbkowania Wan dla serii finałowej ustalono na etapie pilotażu według przypiętego oficjalnego szablonu: Euler/simple, 20 kroków, CFG 3,5, shift 8 i podział 10 + 10 między ekspertów. Sprawdzamy dłuższe ujęcie: 241 klatek zamiast 81 z szablonu. To opis ustawień, nie dowód ich wpływu na konkretny efekt wizualny. FP16 dotyczy ekspertów dyfuzyjnych Wan, a nie całego stosu. Podobnie NVFP4 nie oznacza, że każdy komponent LightWan czy LTX działa w czterech bitach.
Dane potrzebne do odtworzenia porównania znajdują się w protocol.json i workflows.json: wersje programów, zależności, ustawienia i sumy kontrolne. Opisują również poprawki zgodności w osobnej kopii kodu. Zachowujemy oryginalne źródła i historię zmian.
Przy przygotowaniu plików do odtwarzania porządkujemy nagłówek MP4 bez ponownego kodowania obrazu. Porównanie pakietów, znaczników czasu i wszystkich odkodowanych klatek potwierdza, że nie zmienia to filmu ani jego tempa; pliki źródłowe pozostają zachowane.
241 klatek przy 16 kl./s daje w prezentacji 15,1 s; 361 klatek przy 24 kl./s daje 15 s. Końcowy raster wynosi 1280 × 704, a nie pełne 1280 × 720. Nie wyrównujemy długości interpolacją, sklejaniem fragmentów ani zmianą tempa. Różna liczba klatek pozostaje częścią praktycznej konfiguracji.
Granice czasu oraz pochodzenie audio
Każdy finałowy klip zaczyna pracę w osobnym procesie aplikacji, bez modelu pozostawionego przez poprzednie zadanie. Systemowa pamięć podręczna plików nie jest czyszczona. Zachowujemy też pliki skompilowanych funkcji GPU, które mogą powstać podczas pilotaży. Wynik nie przedstawia więc ani pierwszego uruchomienia na świeżo zainstalowanym środowisku, ani czasu odpowiedzi stale działającego API z gotowym modelem. Suma etapów nie obejmuje kolejki i przerw między zadaniami.
Mierzymy przygotowanie modelu, przetworzenie obrazu i opisu, generowanie, zamianę wyniku modelu na klatki oraz zapis MP4. Poza pomiarem pozostają tworzenie ilustracji wejściowych, pobieranie wag, start programu i wczytanie jego bibliotek, pełne sprawdzanie sum kontrolnych dużych plików oraz końcowa ocena mediów. Niewielki narzut sterowania zadaniem mieści się w podanym czasie. Samo utworzenie obiektu modelu w programie nie oznacza jeszcze załadowania wszystkich jego danych — część może być wczytywana później.
Dla osobnego audio analogiczny zakres zaczyna się po importach i kończy zapisaniem udźwiękowionego MP4. Obejmuje przygotowanie Retake, przetworzenie wejściowego filmu, generowanie dźwięku, odrzucone dekodowanie obrazu, zapis surowego WAV, sprawdzenie sygnału oraz kodowanie AAC i połączenie ścieżek. LTX generujący oba rodzaje danych wspólnie nie ma wyodrębnionego czasu „samego audio”.
Retake otrzymuje osobny opis odgłosów dla danej sceny. Obraz wejściowy do tego etapu, liczba klatek i tekstowe wskazówki różnią się od wspólnego generowania LTX; wyniki nie izolują więc samej metody tworzenia dźwięku.
Przy dodawaniu dźwięku przez LTX Retake nie zmieniamy oryginalnego obrazu. Część modelu odpowiedzialna za wideo nie otrzymuje dodatkowego szumu, a do końcowego MP4 trafia oryginalny strumień wideo, nie obraz odtworzony wewnętrznie przez Retake. Sprawdzamy zgodność pakietów, znaczników czasu i zdekodowanych klatek. Zachowujemy niemy film oraz niezmieniony wygenerowany WAV. Dźwięk może naturalnie skończyć się do 40 ms przed obrazem; rzeczywistą różnicę zapisujemy, bez dodawania ciszy czy skracania filmu. Jeśli dźwięk jest dłuższy, przy połączeniu ścieżek można odciąć jedynie nadmiar do 0,5 s.
W każdym z sześciu osobnych etapów audio wygenerowana ścieżka kończy się 12,5 ms przed obrazem. Zachowaliśmy tę naturalną różnicę: bez dopisywania ciszy, rozciągania dźwięku ani zmiany jego głośności.
Jak liczymy zużycie energii i sprawdzamy wyniki
Energia pozostaje dodatkowym pomiarem dla osób analizujących obciążenie sprzętu. Watogodziny, czyli Wh, dotyczą samej karty GPU, nie całego serwera ani rachunku za prąd. Dla wygody poniżej zestawiamy je z zajęciem pamięci z tych samych prób.
| Scena | Wariant | VRAM: film [GiB] | VRAM: osobny dźwięk [GiB] | Energia GPU: suma [Wh] |
|---|---|---|---|---|
| Domek nad jeziorem | Wan2.2 | 81,1 | 77,7 | 607,7 |
| Domek nad jeziorem | LightWan2.2 | 53 | 77,7 | 16,2 |
| Domek nad jeziorem | LTX-2.5 | 29,2 | wspólnie z obrazem | 4,9 |
| Rajd na szutrze | Wan2.2 | 81,1 | 77,7 | 606,4 |
| Rajd na szutrze | LightWan2.2 | 53 | 77,7 | 16,2 |
| Rajd na szutrze | LTX-2.5 | 29,2 | wspólnie z obrazem | 4,5 |
| Żółw nad rafą | Wan2.2 | 81,1 | 77,7 | 606,2 |
| Żółw nad rafą | LightWan2.2 | 53 | 77,7 | 16,3 |
| Żółw nad rafą | LTX-2.5 | 29,2 | wspólnie z obrazem | 4,7 |
Przeliczniki czasu w głównej części artykułu powstają z niezaokrąglonych czasów etapów oraz długości wyliczonej z liczby klatek i klatkażu. Dla każdego wariantu sumujemy trzy sceny, dzielimy przez łączną długość lub liczbę klatek i dopiero wtedy zaokrąglamy do jednego miejsca po przecinku. Średni czas na klatkę obejmuje więc również przygotowanie modeli i dźwięk; nie jest opóźnieniem pojedynczej klatki ani szybkością odtwarzania.
Szacunek 9000 klatek zakłada liniowy koszt obrazu. Dla osobnego audio porównaliśmy skalowanie według długości filmu oraz prostsze skalowanie całego czasu według liczby klatek. Stąd szerszy, orientacyjny zakres LightWan; Retake również przetwarza klatki wejściowe, więc żaden z tych wariantów nie jest zweryfikowaną prognozą. Dla wspólnego obrazu i dźwięku LTX wykorzystujemy czas całego etapu. Podane szerokie zaokrąglenia nie są przedziałami ufności ani gwarantowanymi granicami czasu.
Zużycie energii wyliczamy z odczytów mocy GPU podczas tego samego etapu, którego czas podajemy w tabeli. Pomiędzy kolejnymi odczytami przyjmujemy liniową zmianę mocy; technicznie jest to całkowanie metodą trapezów z interpolacją granic. Odczyty muszą obejmować początek i koniec pomiaru, bez luk dłuższych niż 5 s. Inaczej oznaczamy energię jako niedostępną. Najwyższe zajęcie VRAM wybieramy z odczytów tego etapu, także tych obejmujących jego granice. Bardzo krótki skok pamięci może wystąpić między odczytami i pozostać niewykryty.
Energia obejmuje kartę GPU, bez procesora, wentylatorów, dysków i strat zasilacza. Gdy brakuje prawidłowego pomiaru jednego etapu, suma film–audio pozostaje niedostępna, a nie równa zero. Sumujemy pełne wartości i dopiero potem zaokrąglamy do najwyżej jednego miejsca po przecinku; dlatego suma widocznych liczb może nieznacznie odbiegać od pokazanej sumy.
RAM całego hosta, jeżeli ma rzeczywiste próbki w odpowiednim oknie, jest raportowany osobno od VRAM i pamięci procesu. W Wan pochodzi z telemetrii danego zadania; brak takich próbek pozostaje brakiem danych. Nie zastępujemy ich rozmiarem limitu pamięci ani licznikiem alokacji biblioteki. GiB oznacza 2³⁰ bajtów. Minuty, sekundy i sumy zaokrąglamy niezależnie z pełnych wartości, nigdy przez przeliczanie już zaokrąglonej tabeli.
Wynik dopuszczany do zestawienia musi mieć potwierdzone ukończenie, zatrzymanie i zakończenie kontrolowanego chłodzenia, zgodne wejścia i konfigurację oraz zachowane pliki z sumami kontrolnymi. To kontrola poprawności przebiegu i plików, odrębna od oceny samego materiału.
Jak oceniliśmy obraz i dźwięk
Qwen2.5-Omni-7B sprawdził najpierw sam dźwięk, bez obrazu i podpowiedzi, jaka scena miała powstać. Osobno przeanalizował dźwięk wraz z dwiema klatkami filmu na sekundę. Pytania dotyczyły rozpoznanych odgłosów, ich związku z obrazem, ewentualnej mowy lub muzyki i niepewności odpowiedzi. To dwie osobne analizy tego samego modelu, nie opinie dwóch ekspertów.
Asystent AI przejrzał też nieruchome kadry: po jednym na sekundę, od początku do czternastej sekundy, oraz kadr z 14 s w pełnej rozdzielczości. Opisy dotyczą widocznych obiektów, zmian ich kształtu i kompozycji. Przy scenach oddzielamy te obserwacje od raportu o dźwięku.
Taka ocena nie jest odsłuchem człowieka ani obejrzeniem całego ruchu. Próbkowanie obrazu nie potwierdzi dokładnej synchronizacji każdego odgłosu. Model może coś przeoczyć lub błędnie rozpoznać, więc raport nie gwarantuje braku mowy, muzyki czy usterek. Przydatność do konkretnego projektu nadal wymaga oceny całego klipu.
Procedurę i zakres wykonanej oceny opisuje review-method.json. Ten etap odbywa się poza pomiarem generowania i nie powiększa czasu tworzenia klipu w tabeli. Zachowujemy różnice między raportami: opis obrazu nie jest dowodem, że w dźwięku rzeczywiście występuje to samo zdarzenie.
Krótki słownik
I2V to generowanie wideo na podstawie obrazu. Kl./s określa liczbę wyświetlanych klatek na sekundę, a krok — etap obliczeń modelu. VRAM to pamięć karty GPU. Destylacja przygotowuje model do krótszego przebiegu generowania; kwantyzacja zapisuje część liczb w bardziej zwartej postaci. Sparse attention ogranicza wybrane obliczenia zależności wewnątrz modelu. Enkoder tekstu przetwarza opis na dane dla modelu, a dekoder zamienia wewnętrzną reprezentację na widoczne klatki lub dźwięk.