Czy lokalny model potrafi wykonać zadanie programistyczne równie skutecznie jak płatna usługa? W naszym wcześniejszym teście Qwen3.8-Flash-Next i GPT-6 Astra uzyskały po 15 zaliczeń na 15 prób. Sprawdzamy, co ten remis oznacza dla osoby wybierającej model do pracy z kodem. Wynik obejmuje pięć zadań, każde powtórzone trzykrotnie. Nie dowodzi ogólnej równości obu modeli.
Co dokładnie sprawdzamy?
Przygotowaliśmy niewielkie zadania inspirowane pracą przy aplikacjach: obsługę dat, eksport danych, reakcję wykresu na ruch myszy, porządkowanie kodu faktur i testy wykrywające błędy. Każde miało określony zakres oraz sprawdzenia akceptacyjne. Zaliczenie wymagało przejścia całego zestawu sprawdzeń. Częściowo poprawny kod nie wystarczał.
Punktem odniesienia była GPT-6 Astra, uruchamiana przez Codexa z poziomem rozumowania xhigh. Model działał w usłudze OpenAI, a pliki i testy obsługiwano lokalnie na Linuxie. Qwen pracował na naszym serwerze z kartą NVIDIA RTX PRO 6000 Blackwell Max-Q i 96 GB pamięci GPU.
Test dotyczył agenta, czyli modelu korzystającego z narzędzi. Mógł czytać pliki, zmieniać kod, uruchamiać polecenia i poprawiać własne rozwiązanie po sprawdzeniu. To inny sposób pracy niż wygenerowanie gotowego kodu w jednej odpowiedzi.
Każda konfiguracja otrzymywała te same pięć zadań, po trzy próby, z limitem 20 minut na sesję. Zachowaliśmy wszystkie punktowane wyniki. Serie wykonano w różnych terminach i konfiguracjach, dlatego porównujemy działające zestawy modelu i narzędzi. Wcześniejsze błędy materiałów oraz programu oceniającego mają udokumentowane korekty, stosowane wspólnie do ocenianych rozwiązań.
Wyniki pięciu zadań
Oznaczenia 27B i 122B mówią o przybliżonej liczbie miliardów parametrów, nie gigabajtach. Q4, Q5 i Q8 opisują format zapisu wag. Niższa precyzja pozwala oszczędzić pamięć, ale jej wpływ na wynik trzeba sprawdzić w zadaniu.
Astra i Flash Next w trybie xhigh uzyskały po 15/15. Najbliżej znalazł się Qwen3.8-27B Q4 z kontekstem 128k: 13 pełnych zaliczeń na 15 prób. Znacznie większy Qwen3.5-122B Q5 zakończył serię wynikiem 8/15. Pozostałe sprawdzone konfiguracje miały niższą skuteczność w tym zestawie.
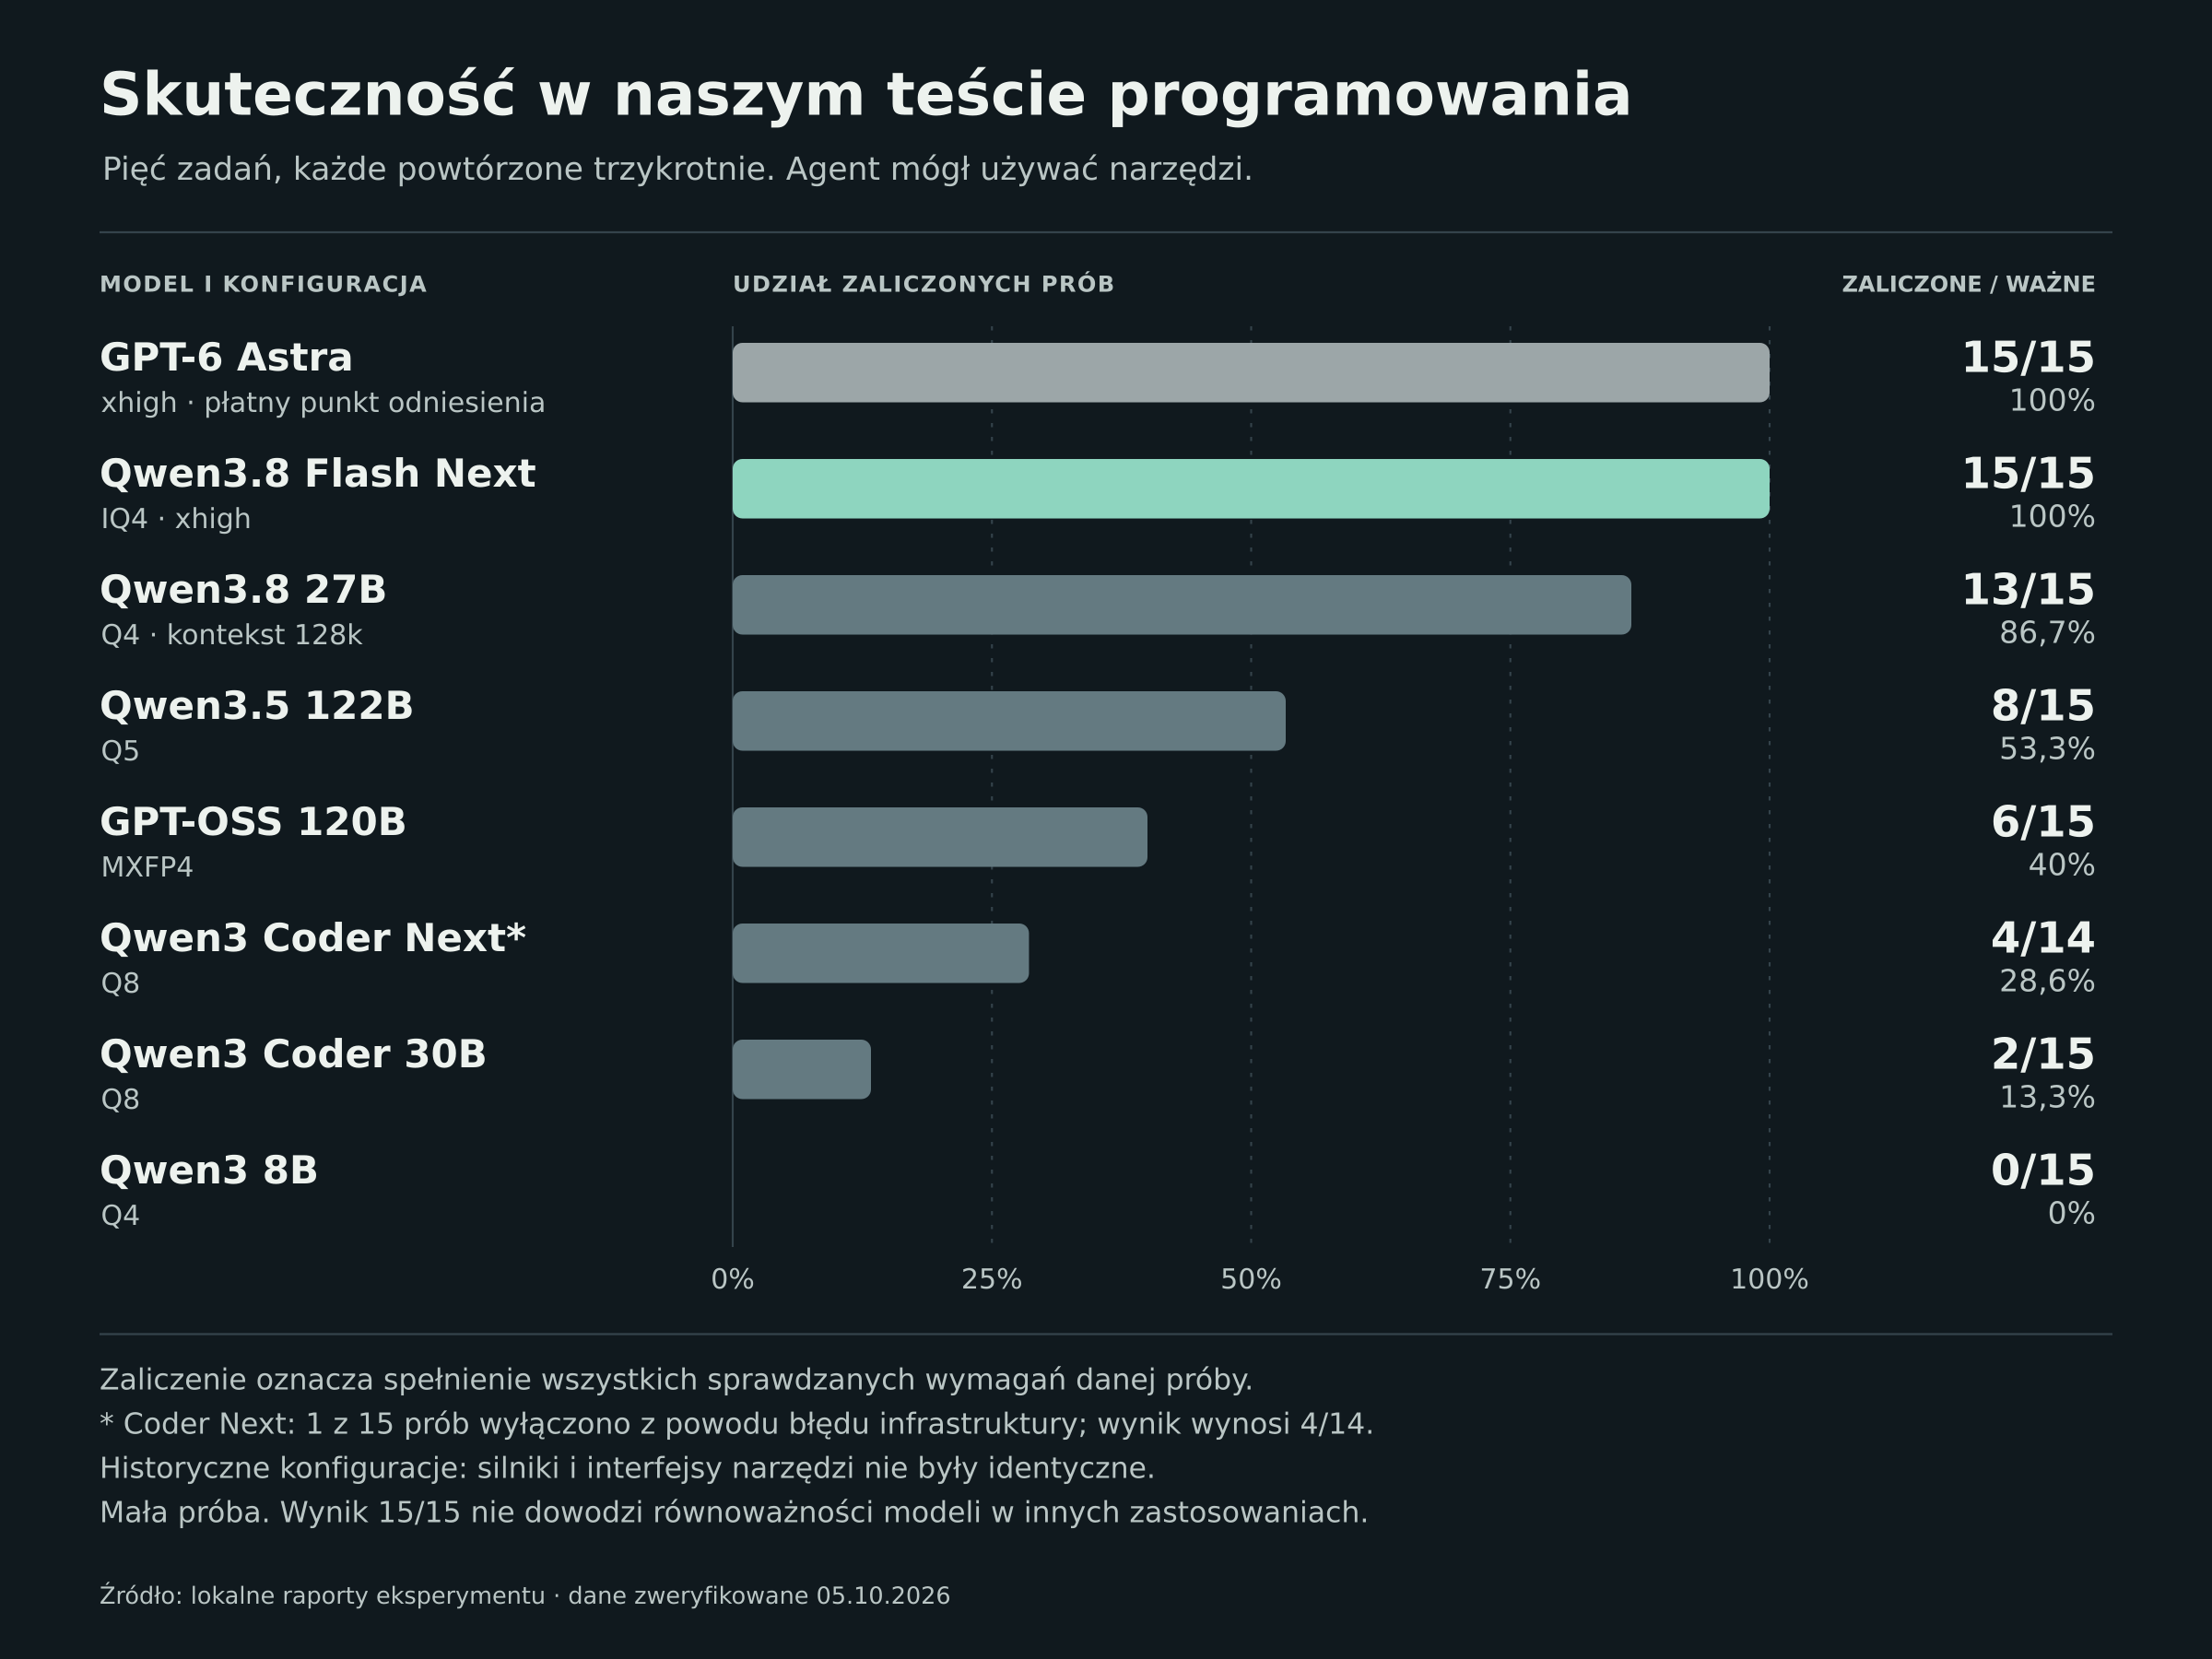
Wyniki wykresu w tabeli
| Model i konfiguracja | Zaliczone / ważne próby | Odsetek zaliczeń |
|---|---|---|
| GPT-6 Astra · xhigh | 15/15 | 100% |
| Qwen3.8 Flash Next · IQ4 · xhigh | 15/15 | 100% |
| Qwen3.8 27B · Q4 · 128k | 13/15 | 86,7% |
| Qwen3.5 122B · Q5 | 8/15 | 53,3% |
| GPT-OSS 120B · MXFP4 | 6/15 | 40% |
| Qwen3 Coder Next · Q8 | 4/14 | 28,6% |
| Qwen3 Coder 30B · Q8 | 2/15 | 13,3% |
| Qwen3 8B · Q4 | 0/15 | 0% |
Dla Coder Next wykluczono jedną awarię infrastruktury: wynik 4/14. Historyczne konfiguracje korzystały z różnych silników i interfejsów narzędzi. Mała próba nie dowodzi równoważności modeli w innych zastosowaniach.
GPT-OSS-120B uzyskał 6/15, Qwen3-Coder-Next Q8 4/14 ważnych prób, a Qwen3-Coder-30B Q8 2/15. Qwen3-8B Q4 nie zaliczył w całości żadnej z 15 prób. Piętnastą próbę Coder Next wyłączono z powodu awarii infrastruktury; nie uznaliśmy jej za błąd kompetencji modelu. Sama nazwa „Coder” ani większa liczba parametrów nie zapewniły przewagi w naszym sposobie pracy.
Flash był blisko Astry także czasowo. Mediana całej sesji wyniosła około 4 minut i 24 sekund, wobec 4 minut i 16 sekund Astry. Czas obejmował edycje, polecenia i dojście do zakończenia pracy. Pierwszy komunikat „sprawdzę pliki” nie oznaczał gotowego rozwiązania. Przy tak małym zestawie osiem sekund różnicy nie stanowi mocnego dowodu przewagi szybkości.
Mediana pokazuje środek uporządkowanych czasów prób; przy parzystej liczbie wyników jest średnią dwóch środkowych. Pomaga opisać typowy czas, lecz nie jest gwarancją oczekiwania przy dowolnym zadaniu.
Co poza poprawnością kodu?
Użytkownik potrzebuje wiedzieć, co zmieniono, dlaczego i jakie testy rzeczywiście wykonano. Wyjaśnienia ocenialiśmy osobno, na podstawie odpowiedzi, zmian w kodzie i zapisanych poleceń. W starszej serii Flash otrzymał średnio 7,7/10, a Astra 10/10. Recenzje Flash wskazywały między innymi rozwlekłość oraz deklaracje szerszej weryfikacji, niż potwierdzały dowody.
To pomocnicza ocena AI z tej samej rodziny co model odniesienia. Recenzent nie widział nazw ocenianych modeli, ale nie było niezależnej recenzji ludzi ani potwierdzenia identycznych wersji recenzenta w obu seriach. Wynik 10/10 oznacza spełnienie konkretnej rubryki, nie bezbłędność Astry. Ocenialiśmy widoczne wyjaśnienia i dowody, bez ukrytego toku rozumowania.
Ile pamięci potrzebował Flash Next?
VRAM to pamięć karty graficznej, a RAM jest pamięcią systemową serwera. W pomiarach używamy GiB, jednostki różniącej się od dziesiętnego GB podawanego w specyfikacjach.
Flash Next korzystał z formatu IQ4_NL oraz kontekstu 128k. W starszej serii szczyt zajęcia pamięci GPU wyniósł 72,9 GiB, pozostawiając około 22,7 GiB zapasu względem pojemności raportowanej przez sterownik. Pomiar obejmował działanie serwera modelu wraz z przygotowaniem i testami, przy jednej sesji naraz.
Wszystkie warstwy transformera i pamięć podręczna kontekstu znajdowały się na GPU. Część embeddingów, czyli tabel reprezentujących fragmenty tekstu, korzystała jednak z RAM serwera. Według karty producenta Flash Next ma rdzeń liczący 125 miliardów parametrów, około 6 miliardów aktywnych podczas obliczeń oraz dodatkowe 51 miliardów parametrów embeddingów. Liczba aktywnych parametrów nie określa rozmiaru całego modelu do przechowania.
Co daje firmie model na własnym serwerze?
Lokalny model pozwala firmie zachować kod, dokumenty, pytania i wygenerowane wyniki we własnym środowisku, bez wysyłania ich do zewnętrznego API modelu. Przy analizie wewnętrznych materiałów może to ułatwić kontrolę nad miejscem przetwarzania informacji i osobami, które mają do nich dostęp.
Firma może ustalić uprawnienia, zasady zapisywania logów i okresy przechowywania danych. Może również wybrać wersję modelu i zdecydować, kiedy ją zaktualizować. Pomaga to zachować stałą konfigurację dla powtarzalnych zadań i sprawdzić zmiany przed wprowadzeniem ich do codziennej pracy.
Warunkiem jest lokalność całego procesu. Aplikacje, integracje, telemetria i kopie zapasowe nie mogą wysyłać tych danych poza firmę. Po przygotowaniu modelu, oprogramowania i potrzebnych plików można też pracować offline, jeśli żadna część zadania nie wymaga zewnętrznej usługi.
To większa kontrola nad obiegiem danych, nie gwarancja braku wycieku; korzystanie z zewnętrznej usługi również nie oznacza upublicznienia danych.
Firma nadal musi konfigurować i utrzymywać system, zapewnić pamięć oraz energię i zarządzać dostępem. Nasze testy nie obejmowały pełnego kosztu posiadania ani progu opłacalności względem abonamentu.
Czy wyższe ustawienie daje lepszy wynik?
Po pierwszym porównaniu przygotowaliśmy sześć nowych zadań i 72 kolejne próby. Flash Next pracował z ustawieniami xhigh i medium, a Qwen 27B w wariantach Q4 i Q8. Każda konfiguracja otrzymała po 18 prób. Astra nie uczestniczyła w tej serii, więc jej wcześniejszego 15/15 nie zestawiamy z nowymi wynikami jako wspólnego testu.
| Konfiguracja | Pełne zaliczenia | Mediana całej sesji |
|---|---|---|
| Flash Next medium | 18/18 | 2 min 42 s |
| Flash Next xhigh | 18/18 | 3 min 17 s |
| Qwen 27B Q4 xhigh | 18/18 | 5 min 14 s |
| Qwen 27B Q8 xhigh | 18/18 | 6 min 40 s |
Flash medium miał medianę czasu krótszą o około 18% niż xhigh, przy tej samej liczbie zaliczeń. Zmieniliśmy poziom rozumowania, nie wielkość modelu. Q8 nie poprawił skuteczności względem Q4, a jego mediana była dłuższa o około 27%. Warianty Q4 i Q8 wykonywano kolejno blokami, co ogranicza interpretację czasu. Wszystkie konfiguracje zaliczyły wszystko: do dalszego rozróżnienia ich poprawności potrzeba trudniejszych zadań.
Co zmienia większy limit tokenów?
Token jest fragmentem tekstu: słowem, częścią słowa albo znakiem. Limit generacji określa budżet tworzonej odpowiedzi. To inne ustawienie niż kontekst, który wyznacza pojemność materiału obsługiwanego przez model.
Osobno sprawdziliśmy kod tworzony w jednej odpowiedzi, bez możliwości uruchamiania plików i testów przez model. Przy limicie 16k tokenów Flash uzyskał 0/6, przy 32k 2/6, a przy 64k 4/6. Qwen 27B osiągnął odpowiednio 1/6, 3/6 i 4/6. Wyniki były słabsze niż przy pracy agenta z narzędziami.
Limit obejmował również tokeny rozumowania. Czasem kończył się, zanim pojawił się widoczny kod. Większy budżet pomagał, ale pozostawały ucięcia i błędy. Badaliśmy tylko dwa zadania, a wraz z budżetem tokenów zwiększono limit czasu. Wyniku nie można przypisać wyłącznie liczbie tokenów ani przenosić na całą pracę programisty.
Darmowy model i płatna usługa: remis w naszym teście
Qwen Flash Next i GPT-6 Astra uzyskały po 15/15 w pięciu zadaniach powtórzonych trzykrotnie. To remis pod względem pełnych zaliczeń w naszym zestawie zadań. Astra otrzymała wyższą ocenę wyjaśnień w pomocniczej recenzji AI.
Model dostępny do pobrania bez opłat nie musi więc dawać gorszych wyników niż płatna usługa. Wagi Flash Next można pobrać bez opłat na warunkach licencji producenta; infrastruktura i utrzymanie nadal kosztują.
Jeśli chcesz przeprowadzić własne porównanie, sprawdź ofertę serwera GPU Server Hub.
Źródło wyników: własne testy wykonane od 29 września do 5 października 2026 r. Dane obejmują osobno pierwotną serię programowania, późniejsze porównanie czterech konfiguracji oraz próbę zwiększenia limitu generacji. Ilustracja główna: AI. Wykres: opracowanie na podstawie zapisanych wyników.